新西伯利亚国立大学高等信息学学院PWA课表诞生记:从第一行代码到数百名学生日常依赖
新西伯利亚国立大学高等信息学学院PWA课表诞生记:从第一行代码到数百名学生日常依赖
在学生时代,有些糟糕的体验总会被当作无法避免的既定现实。对于新西伯利亚国立大学高等信息学学院(VKI NSU)的学生而言,多年以来的噩梦就是每天查询课程表。学院教务处每天仅以多页PDF文件的形式发布课表,排版完全由人工排版完成,没有任何可调用的程序接口(API)。
每天清晨,数百名学生都在重复着同样枯燥且繁琐的操作:打开学院官网,将沉重的PDF文件下载到手机里,在阅读器中用双指吃力地缩放密密麻麻的网格,在几十个外观完全相同的单元格中费劲地寻找自己班级的代号。更糟糕的是,课表并不是看一眼就够了,而是每堂课下课铃响后都必须重新确认:查看教室编号、核对授课教师,或者确认某堂课是否临时被调到了其他教学楼。
雪上加霜的是物理环境:学院历史悠久的红砖建筑有着厚达一米的实心砖墙,而在寒冷的秋冬季节,体育课往往在地下健身房进行,这些地方变成了名副其实的“法拉第笼”,手机网络信号骤降至绝对零度。如果学生忘记提前将文件保存在手机存储中,就只能在紧闭的教室门前陷入完全的信息盲区。
在这篇文章中,我将完整回顾这个独立PWA服务的开发全过程:从最初深夜幼稚的尝试与挫败,到走向成熟的架构选型、Web技术权衡、复杂的PDF表格逆向工程,以及打造出真正可靠的离线优先客户端。
1. 二月的起跑失误:Gravity UI、盲目AI写代码与转战工美大学
项目的萌芽始于2月5日。临近午夜,脑海中突然冒出一个念头:在2025年,作为西伯利亚顶尖IT学院的学生,为什么每天早晨还要强忍眼痛去看原始笨拙的文档?外面世界的Web技术早已经历了现代响应式框架和渐进式应用的飞跃。
一股强烈的冲动涌上心头:要在这一夜之间构建出一个迅捷、美观、现代化的课表Web应用。在设计系统的选型上,我选择了Yandex开源的 Gravity UI。它的组件设计极具科技感与极简风格,非常契合严谨的网格数据、班级列表与课表矩阵。
我设计了初始原型,填入了VKI学院的真实课表数据,一边用React搭建界面,一边在后端摸索。然而正是在这里,我第一次跌入了“盲目跟风AI编程(Vibe-Coding)”的泥潭。
当时我完全不算一名Python开发者,对语言生态极其陌生,不懂异步Web框架,更对文档解析底层一无所知。在现代大语言模型盛行的当下,似乎根本不需要去理解PDF的内部机制:把文档直接扔给AI模型,让它写个能输出漂亮JSON的解析器不就行了?
残酷的现实瞬间浇灭了这种不切实际的盲目乐观。
PDF既不是数据库,也不是结构化HTML,更不是电子表格。在底层,它仅仅是一串面向虚拟打印机的低级绘图指令:在物理坐标 (x, y) 处绘制一条矢量线段,在某个特定偏移量放置某个字形符号。源文件中根本没有“行”、“列”或“表格单元格”的语义概念,只有漂浮在二维坐标画布上的可视化线条和离散文本碎片。
随手生成的脚本输出了荒唐混乱的数据:
- 跨班级合班上课的大课单元格被随机指派给了错误的子组。
- 不到半毫米的列宽微小偏移,导致上课时间段与教室编号的对应关系彻底错位。
- 授课教师姓名首字母缩写的各种不规则写法,生成了数十条幽灵般的重复记录。
在深更半夜去深究复杂的坐标数学与矢量启发式算法令人望而生畏。最初的狂热退去,挫败感取而代之,VKI课表项目不得不暂时搁置。这成为了我工程生涯中至关重要的一课:如果你自己都不理解输入数据的底层物理本质,就绝不可能构建出可靠的系统。
不过,前期的投入并没有付诸东流。不久后,我收到了为另一所高校——圣彼得堡国立工业技术与设计大学(sutd.okak.pw)开发课表服务的需求。
两者的对比令人惊叹。与VKI不同,该校的课表以结构极为规范的Excel表格(.xlsx)形式发布,且教务部门不会频繁随性更改结构。利用标准库解析它们如行云流水:严格的行列网格、可预测的单元格索引,完全没有矢量乱象。
原本为VKI量身构思的Gravity UI设计无缝适配了新项目。通过工美大学课表的开发,我从容地打磨了客户端状态管理、组件分层、教学周切换逻辑以及API通信交互。这是一次绝佳的演练阵地,为日后重返母校项目保留了扎实的技术基石。
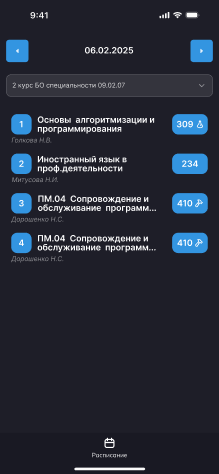
2. 卷土重来:十八岁、挥别Discord机器人与拥抱PWA
初夏时分,我的人生迎来了几个关键节点的交汇。首先是我迎来了十八岁生日——这是一个促使人重新审视精力与时间投入的心理里程碑。其次,我对常年开发Discord机器人产生了彻底、无可挽回的职业倦怠。
多年来,我一直专注于机器人的架构、服务器基础设施和接口集成。但某一刻我猛然清醒:开发机器人不过是在别人的封闭生态里原地打转。我渴望跃迁到更高维度的独立产品开发阶段:打造能够被现实中身边真实人群每日使用、真正解决生活痛点的完整独立Web服务。
在那个被取消的Discord机器人项目中,我已经聘请了一位熟识的优秀设计师 Arlen。我们相识已久,我预先向他支付了一笔项目定金,当时他刚在Figma中完成了初步的界面框架图。
我找到他对他说:“机器人项目取消了,我不想再做它了。不如我们一起来为我们学院做一款体验极致、现代美观的课表应用吧。”
Arlen毫不犹豫地赞同了这个提议。这个项目迅速超越了普通外包委托的范畴,升华为一场纯粹出于热爱的共同创业——为了积累工程实战经验、打造顶级作品集案例,更为了切实帮助身边的同学们。
在设计初期,我们遇到了一个有趣的现实挑战。Arlen最初只绘制了纯亮色主题的界面原型。原因非常现实:要在Figma中完整配置支持明暗主题自由切换的设计令牌(Design Tokens)和变量,需要开通付费团队版订阅。对于一个非营利的学生开源项目而言,每个月为此付费并不划算,因此暗黑模式后来是由我手动逐一校准对比度并编写样式实现的。
核心架构选型:为什么必须是渐进式Web应用(PWA)?
我们面前摆着一个根本性的架构抉择:以何种形态将产品交付给用户?平台的选择决定了整个项目的生死。
开发原生iOS(Swift)和Android(Kotlin)应用的方案几乎在第一时间就被否定,原因十分明确:
- 财务与支付门槛: 苹果开发者计划(Apple Developer Program)每年收费99美元。在当前环境下,一名身处俄罗斯的学生支付该款项极其繁琐。为一个学院级非营利工具每年自掏腰包续费并不合理。
- 审核延迟风险(App Store Review): 一旦学院教务处突击调整PDF格式或大课结构,客户端必须能在几分钟内完成紧急热更新。如果需要苦等苹果团队2到3天的漫长审核,全院学生将被迫在半周时间里无课表可用。
- 维护成本过高: 为一个聚焦实用属性的学生查阅工具维护两套完全独立的原生代码库,人力开销过于沉重。
而在手机浏览器中保存普通书签同样无法解决痛点。学生在匆忙赶课的路上,根本不可能忍受在几十个标签页中艰难查找、手动输入网址并在教学楼前苦等网络连接的低劣体验。
最终的答案是 渐进式Web应用(Progressive Web App, PWA) 标准,它完美融合了Web的轻敏与原生的交互质感:
- 一键安装至系统主屏幕: 用户通过浏览器即可直接安装,获得独立的系统桌面图标,以无地址栏的纯净独立窗口(
display: standalone)启动,交互质感与原生应用毫无二致。 - 无感秒级静默更新: 每次打开应用时,后台自动拉取最新打包产物,无需前往应用商店手动下载。
- 真正的离线优先(Offline-First): 结合Service Worker与Cache Storage缓存机制,即使在地下健身房的飞行模式下,也能以0毫秒的速度闪电般打开课表。
在基于Vite的构建流中,我们引入了 vite-plugin-pwa 插件并选用了 injectManifest 注入策略。这赋予了我们对Service Worker全生命周期的绝对控制权,将静态资源的预缓存与系统级Push通知完美结合:
import { defineConfig } from "vitest/config";
import { VitePWA } from "vite-plugin-pwa";

export default defineConfig({
    plugins: [
        VitePWA({
            srcDir: 'src',
            filename: 'sw.ts',
            registerType: 'autoUpdate',
            strategies: 'injectManifest',
            manifest: {
                id: 'vki',
                name: 'ВКИ НГУ',
                short_name: 'ВКИ НГУ',
                start_url: '/?v=102',
                display: 'standalone',
                theme_color: '#007AFF',
                background_color: '#007AFF',
                icons: [
                    {
                        src: 'pwa-192x192.png',
                        sizes: '192x192',
                        type: 'image/png'
                    },
                    {
                        src: 'pwa-512x512.png',
                        sizes: '512x512',
                        type: 'image/png'
                    }
                ]
            }
        })
    ]
})
而核心Service Worker脚本文件(sw.ts)的实现兼顾了纯粹与高效:
/// <reference lib="webworker" />
import { precacheAndRoute } from "workbox-precaching";

precacheAndRoute(self.__WB_MANIFEST)

declare const self: ServiceWorkerGlobalScope

self.addEventListener('push', (event: PushEvent) => {
    const data = event.data?.json() || {}

    self.registration.showNotification(data.title || 'ВКИ НГУ', {
        body: data.body || 'Новое обновление расписания',
        icon: '/pwa-192x192.png',
        badge: '/pwa-72x72.png'
    })
})
得益于这一架构,用户不仅获得了开箱即用的流畅首屏,还能在操作系统通知中心直接接收到及时的课表推送。
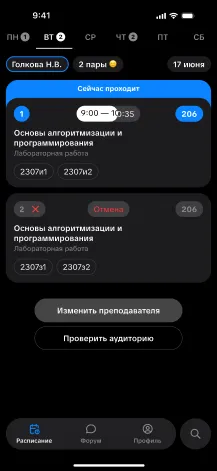
3. 第一代架构:服务端解析器与客户端离线缓存
6月21日,项目正式进入了全速研发的攻坚阶段。 已经没有退路:再无任何借口与拖延,距离金秋新学期只剩短短两个多月,必须在这段时间内从零搭建起一条高可靠的生产流水线。
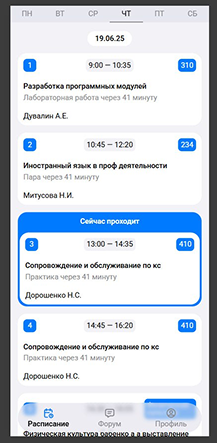
首先是对现存方案的调研。此前曾有高年级同学尝试过自动化解析,留下了开源项目 VkiHub。
深入研读VkiHub带来了极大的启发。其核心价值在于对业务领域的洞察:代码中积累了用于匹配班级代号和已知文档特殊格式的基础正则表达式。然而直接复用VkiHub是不现实的:
- 该项目采用了陈旧臃肿的技术栈,对低配服务器的资源消耗极高。
- 完全缺乏PWA和移动端离线支持的架构考量。
- 单体紧耦合设计固化了过往的假设,无法支撑客户端功能的动态扩充。
我们决定在现代化技术栈上重新构筑后端:FastAPI + Uvicorn + PyMuPDF + Camelot。
第一代解析器核心剖析
后端的首要职责十分专一:定时轮询学院官网,下载新鲜出炉的PDF排课表,确定性地抽取网格数据并转换为规范干净的JSON格式。
在表格抽取方案上,我们采用了开源库 Camelot。为了大幅提升渲染效率且摆脱对外部厚重CLI工具的依赖,我们基于极速底层库 pymupdf 定制开发了轻量级渲染转换器 ConversionBackend。它能在内存中以120 DPI将PDF即时渲染为位图,用于计算机视觉对矢量线条的形态学分析:
class ConversionBackend:
    def convert(self, pdf_path, png_path):
        pymupdf.Document(pdf_path)[0].get_pixmap(dpi=120).save(png_path)

class Parser:
    def __init__(self):
        self.conversion_backend = ConversionBackend()

    def extract_teacher_name(self, content):
        teacher_match = re.findall(r'\b[А-ЯЁ][а-яё]*\s[А-ЯЁ]\.\s?[А-ЯЁ]\.?\b', content)
        teacher = teacher_match[0] if teacher_match else ''
        if content.startswith('НГУ') or content.startswith('Нгу'):
            teacher = self._get_teacher(content)

        if teacher:
            formatted_teacher = teacher + '.' if not teacher.endswith('.') else teacher
            if formatted_teacher[-3] == ' ':
                formatted_teacher = formatted_teacher[:-3] + formatted_teacher[-2:]
            return formatted_teacher, content.replace(teacher, formatted_teacher)

        return teacher, content

    def extract_classroom(self, content):
        classroom_match = re.findall(r'\b\d{3}[a-zа-яё]?\b', content)
        classroom = classroom_match[0] if classroom_match else ''

        if content.startswith('НГУ') or content.startswith('Нгу'):
            classroom = f'НГУ {classroom}'

        for special_room in ['Читальный зал', 'Актовый зал', 'Физкультура', 'Физическая культура']:
            if special_room in content:
                classroom = special_room
                break

        return classroom
数据清洗被赋予了最高优先级:
- 授课教师: 人工排版的缩写五花八门(如
Ivanov I.I.、Ivanov I. I.或漏写句号的Ivanov I.I)。正则表达式配合格式化函数,将其统一规范为首字空格与末尾句号的严谨标准。 - 授课教室: 除了常规的三位门牌号(
214、308a),解析器还能识别非数字场地(“阅览室”、“大礼堂”、“体育课”),以及带有НГУ前缀的大学本部教学大楼。
第一代Camelot调优参数兼顾了执行效率与常规线段识别:
tables = camelot.read_pdf(
    pdf_path,
    pages='all',
    copy_text=['h', 'v'],
    line_scale=55,
    joint_tol=12,
    line_tol=12,
    backend=self.conversion_backend
)

schedule = {}
for table in tables:
    data = table.df.values.tolist()
    if 'время' in data[0]:
        continue

    data = self.process_table_data(data)
    data, week_dates = self.fix_missing_data(data)

    for i in range(1, len(data)):
        row = data[i]
        for j in range(2, len(row)):
            if row[1].endswith('.5') and data[i][j] == data[i-1][j]:
                continue

            content = self.parse_lesson_content(row[j])
            teacher, content = self.extract_teacher_name(content)
            classroom = self.extract_classroom(content)
            group_name = data[0][j]
            day_name = row[0]

            if group_name not in schedule:
                schedule[group_name] = {}

            if day_name not in schedule[group_name]:
                schedule[group_name][day_name] = {
                    'date': week_dates.get(day_name, ''),
                    'lessons': []
                }

            schedule[group_name][day_name]['lessons'].append({
                'content': content,
                'number': row[1],
                'group': group_name,
                'teacher': teacher,
                'classroom': classroom,
                'cancelled': 'отмена' in row[j].lower()
            })
请注意针对 .5 节次的处理机制:当教务处将单节大课拆分为两组分班实验,或根据单双周(分子/分母)排定不同科目时,节次带上小数后缀,确保了时间维度的严格顺序。
客户端工程与 Stale-While-Revalidate(SWR)
在前端层面(React + Redux Toolkit),我们确立了另一个严苛目标:在任何网络状况下,应用界面必须以零感知延迟呈现。
如果简单粗暴地将全院所有年级和班级高达数兆字节的完整JSON全量存入浏览器的 localStorage,不仅会迅速触及配额上限,JSON序列化还会显著卡死主渲染线程。
为此,我们在 util.ts 中设计了选择性差异同步机制 syncScheduleCache:
export const syncScheduleCache = (schedule: any) => {
    if (!schedule) return
    const storage = getStorage()
    const favorites = storage.favorite || []
    const params = new URLSearchParams(`?${localStorage.getItem('params') || ''}`)
    const selected = params.get('group') || params.get('teacher') || params.get('classroom') || null

    let cache = getScheduleCache() || {}

    if (selected && schedule[selected]) {
        cache[selected] = schedule[selected]
    }
    favorites.forEach((f: string) => {
        if (schedule[f]) cache[f] = schedule[f]
    })

    for (const key of Object.keys(cache)) {
        if (key !== selected && !favorites.includes(key)) {
            delete cache[key]
        }
    }

    if (Object.keys(cache).length) setScheduleCache(cache)
    else localStorage.removeItem('ci-schedule-cache')
}
该算法严格保留当前用户真正关心的信息:当前选中的班级以及加入收藏的班级/教师列表。所有无用数据自动剥离,使本地持久化缓存维持在数十KB的极小体量。
应用在 App.tsx 中的生命周期挂载遵循经典的 Stale-While-Revalidate (SWR) 缓存重新验证模式:
const cached = getScheduleCache()
if (cached) {
    this.props.setSchedule(cached)
}

const promise = fetch(`${apiUrl}/schedule`).then((r) => r.json()).catch(() => null)

const handleRes = (res: any) => {
    if (res?.ok) {
        this.props.setSchedule(res.result)
        syncScheduleCache(res.result)
    }
}

if (cached) {
    promise.then(handleRes)
} else {
    const res = await promise
    handleRes(res)
}
实际运行流程:
- 若用户此前打开过应用,
getScheduleCache()在0毫秒内唤醒内存中的缓存课表,界面瞬时渲染完成,无任何白屏或加载动画——即使在无信号的地下室亦然。 - 与此同时,网络请求在后台静默发起。
- 当服务端返回最新数据时,应用默默更新Redux状态池并同步本地存储,丝毫不打断用户当前的手势浏览。
- 仅在首次冷启动完全没有本地缓存时,应用才等待服务端响应并渲染界面。
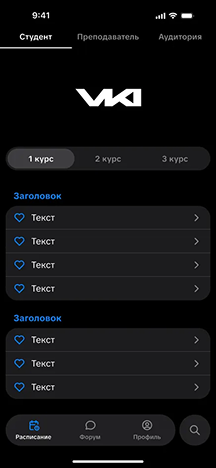
4. 拓展生态系统:账户主页、Web Push 与封闭学生论坛
当基础课表主干被证明坚如磐石之后,自然滋生出进一步拓展的渴望。仅仅充当静态的数据看板未免过于单调,我们希望将其打造成全学院值得信赖的数字化校园枢纽。
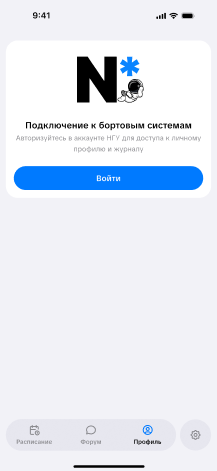
第一步重大改造是引入认证系统与个人主页。安全是重中之重:如果允许通过普通邮箱或社交账号随意注册,平台将在几天内被垃圾信息、负能量和口水战淹没。
我们推行了严谨的工程决策:仅支持使用学院域名为 @mer.ci.nsu.ru 的官方企业Google Workspace账号登录。这一铁律实现了100%可信实名闭环:
- 社区内部成员全部为真实的在读统招学生与教职员工。
- 账号直接展示经学院官方认证的真实姓名。
- 从根源上杜绝了水军刷号与匿名网暴的可能。
完成授权后,用户便可通过VAPID标准协议开启系统级Web Push通知(基于 pywebpush)。服务器生成独一无二的加密浏览器订阅凭证,将其存入数据库并与学生档案深度绑定。
课表更新推送的分发策略蕴含着精妙的工程权衡。教务处从不会在某一瞬间同步发完全部年级文档:文件往往在傍晚分段发布——18:00放出一批,19:30放出一批,接近22:00才放完最后批次。如果后端苦等所有年级全部发布才通知,学生往往要到深夜才能知晓;而如果每解析一个文件就全员群发,又会引发严重打扰与退订风潮。
为此,我们实现了针对性微推送机制:后台解析程序将变动的班级与教师和用户的个性化订阅表进行匹配,仅在特定班级专属PDF解析完毕的那一分钟内,精准下达 2307i1班课表已更新 的靶向系统通知;而针对全院的常规通知,仅在全天全部文件解析完毕(is_complete)时才会触发一次。
封闭式学生论坛
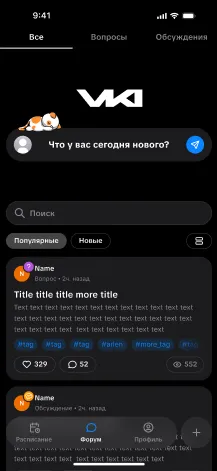
伴随用户体系的落成,我们启动了那个夏天最具野心的功能模块:在PWA内构建一个封闭式学生论坛。我们按照严肃商业社交平台的高标准进行了打磨:
- 双核心内容流分类:
- “求助答疑”:专用于课后作业攻坚、课程实验答疑与毕业设计互助。
- “校园杂谈”:为学生自发活动、黑客马拉松招募队友及日常闲聊提供自由天地。
- 交互式主题色彩标签: 支持按学科分类(如“编程开发”、“高等数学”、“计算机网络”),点击即可在信息流中实现即时过滤。
- 树状评论机制: 支持多级嵌套讨论,新回复将通过系统Web Push实时提醒发帖人。
- 声望系统与SVG身份勋章: 在用户头像旁展示专属徽章——开发者(
badge_dev)、设计师(badge_design)、内测先锋(badge_beta),并公开展示浏览量与点赞互动统计。 - 智能排序算法: 引入热度计算公式
Score = Likes * 3 + Views,将高价值讨论推至信息流前列,过时沉寂的话题自然下沉。 - 服务端防刷保护: 强制设置发帖间隔15分钟冷却期。过快连续发帖将返回HTTP 429并附带精确到秒的解锁倒计时。
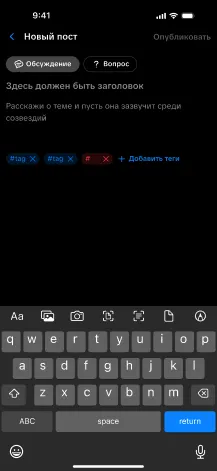
Arlen将发布界面打磨得极其洗练:选择帖子性质、输入标题与正文,并支持交互式标签选择。
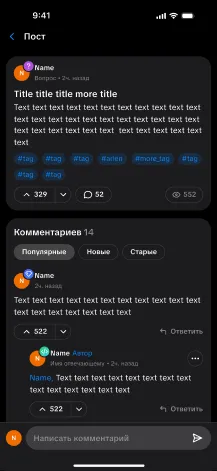
而在帖子详情页中,则展开了包含身份勋章和层级缩进回复的完整讨论楼层。
5. 八月生产发布:现实的撞击与被遗忘的大四毕业班
2025年8月下旬,项目已全量组装完成并在本地完成全链路联调,整装待发。我们租赁了一台性能可靠的Linux VPS,配置Nginx作为反向代理,部署了Let’s Encrypt免费SSL证书,推送了第一个公开正式版PWA。
我们信心满满:视觉经反复推敲、离线经飞行模式实测、论坛运转良好、通知精准直达。万事俱备,只待开学。
然而9月1日如期而至——现实运维的重锤将所有未经推敲的理论假设砸得粉碎。
问题出在:整个7月和8月,后端的解析脚本和前端界面完全基于6月21日的既有文件进行测试。而在6月下旬,大四毕业班早已答辩完毕离校,夏季归档文件中根本就没有四年级的课表。我们犯下了一个典型的、近乎滑稽的新手盲区:我们全身心扑在1、2、3年级的细枝末节上,竟完全忘记了学院里还有一个四年级的存在!
9月1日清晨,当教务处在官网上挂出秋季学期第一批排课表时,服务器迎面撞上了海量从未见过的四年级班级代号与特殊文件。系统彻底瘫痪:解析器在陌生代号上疯狂报错,正则全面崩溃,客户端界面甚至根本没有留出四年级的切换按钮。
9月上旬演变成了一场昏天黑地的紧急热修复马拉松。我们在生产服务器上连夜追加四年级的数据结构适配,修改UI选择器,动态优化正则规则,利用后半夜的新文件进行排查测试。
这场高压洗礼带来了惊人的回报:同学们瞬间领教到了这款应用的便捷。PWA的安装链接在各班级和学生群里如病毒般蔓延。到9月中旬,服务的日活跃用户(DAU)稳定突破了 50人。这是我们斩获的第一个真正意义上的里程碑。
6. 3月15日危机:表格崩溃、幽灵官网与基于Camelot的重构救赎
到了2026年春季,产品步入鼎盛期。日活跃用户(DAU)突破 250人。对于一个在校全日制人数约800人的专科学院而言,这意味着每三个统招生中就有一人在每节课间频繁启动我们的PWA。
然而到了 2026年3月15日——整个项目迎来了决定命运的关键转折点。
这一天同时发生了两起重塑项目命运的大事件:
- 学院教务处彻底更换了课表PDF的生成器模板:字体、版面间距、表头结构及网格物理走向被全盘颠覆。
- 学院管理层大张旗鼓地推出了官方课表网站——
https://table-ci.nsu.ru/。
猛然间,官方系统的登场似乎预示着独立第三方的终结。然而接下来的事实却走向了完全相反的反转。
官方站点是一套近乎难产的产物:它频繁崩溃,把单双周颠倒错乱,将虚构课程排入错误教室;截至2026年9月,该官方站点更是彻底断线瘫痪,访问只会得到死寂的超时网络错误。
但我们的应用同样遭遇了重创:基于VkiHub遗留经验和 line_scale=55 的初代解析器在全新PDF排版前全面失灵。表格解体成碎片,单元格扭曲为乱码,垃圾数据涌入数据库。后台收到了数百条焦急的留言:“课表怎么没了?发生了什么?”。
告别盲目摸索:走向硬核逆向工程
3月15日的崩塌让我彻底警醒:未经深究的盲目AI写代码绝不配活在生产环境。
把破损的PDF扔进模型对话框,寄希望于AI帮你勘误渲染伪影是完全徒劳的。我推掉了一切杂事,通读 Camelot 源码与OpenCV官方技术文档,深入计算机视觉轮廓检测的数学底座。
Camelot拥有两种核心工作模式:
stream模式:基于文本单词间的物理留白距离与空格测算分列。lattice模式:基于OpenCV计算机视觉形态学内核,定位可见矢量网格线的真实交叉点。
新版VKI文件的致命陷阱在于:教务处渲染的单元格边框细到了极致——属于线宽小于0.5pt的所谓“发丝线(Hairlines)”。Camelot默认配置(line_scale=15)乃至我们先前的 line_scale=55 均将其视作光栅化过程中的伪影噪点而直接剔除,导致相连课时被野蛮粘结为单一巨大单元格。
真正的拯救来自对几何物理参数的极限微调:
- 极值放大比例(
line_scale=100): 调大比率迫使OpenCV形态学核对亚像素级微弱线段产生识别响应。 - 缝隙熔接公差(
joint_tol=4与line_tol=2): 允许交点连接处微小的渲染形变,强行闭合细微断痕,重建封闭边界。 - 跨度单元格内容复制(
copy_text=['h', 'v']): 在行列方向自动广播合并单元格文本,避免合班课程丢失从属关系。 - 底层切换为Poppler引擎: 换取至高精度的矢量栅格化保真度。
tables = camelot.read_pdf(
    path,
    pages='all',
    copy_text=['h', 'v'],
    line_scale=100,
    joint_tol=4,
    line_tol=2,
    backend='poppler'
)

for t in tables:
    matrix = self.table_to_matrix(t.df.values.tolist(), file_url)
    data = self.merge(data, matrix)
然而通过Camelot获得工整的表格矩阵仅仅攻克了一半的战役。新版PDF的生成方式改变后,所有的既有文本清洗流程全线失效:教师名同课程名紧密连缀在一起,门牌号嵌入课程正文,文档内还散落着纷繁芜杂的批注(“远程”、“辅导答疑”、“缓考补录”、“期末考试”)。
整套内部归一化与语义解析逻辑必须重起炉灶。第二代解析器的灵魂被浓缩进核心函数 parse_cell(self, text: str):
def parse_cell(self, text: str):
    if not text or not text.strip():
        return None

    text = self.clean_text(text)

    teacher = self.extract_teacher(text)
    classroom = self.extract_room(text)
    isDistance = 'дистанцион' in text.lower() or 'дистант' in text.lower()
    isLecture = 'лекци' in text.lower()
    lesson_text = self.extract_subject(text)
    lesson = self.normalize_lesson(self.remove_duplicate_words(lesson_text))

    if not lesson:
        return None

    if len(lesson.strip()) <= 3 or re.match(r'^[А-ЯЁA-Z]\.?\s*[А-ЯЁA-Z]?\.?$', lesson.strip(), re.IGNORECASE):
        return None

    if not teacher:
        m = re.search(r'\b([А-ЯЁ][а-яё]+(?:ова|ева|ина|ына|ский|цкий|ов|ев|ин|ын|ич|их|ых|юк|ук|ак))\s*$', lesson)
        if m:
            teacher = m.group(1)
            lesson = lesson[:m.start()].strip()

    formatted_lesson = None
    if lesson:
        if lesson.isupper():
            formatted_lesson = lesson[0].upper() + lesson[1:].lower()
        else:
            formatted_lesson = (lesson[0].upper() + lesson[1:]) if lesson.lower() == lesson else lesson

    if classroom and formatted_lesson:
        formatted_lesson = formatted_lesson.replace(classroom, '').strip()

    if formatted_lesson:
        formatted_lesson = re.sub(r'[\s.,:;_-]+$', '', formatted_lesson)

    isIssusing = 'выставле' in text.lower() or 'задолженност' in text.lower() or ('пар' in text.lower() and 'нет' in text.lower()) or not lesson

    return {
        'line': self.remove_duplicate_words(text) if isIssusing else text,
        'lesson': formatted_lesson,
        'teacher': teacher,
        'classroom': classroom,
        'isLecture': isLecture,
        'isDistance': isDistance,
        'isPractice': bool(re.search(r'\bпракт', text.lower())),
        'isExam': 'экзам' in text.lower(),
        'isIssusing': isIssusing,
        'isConsultation': 'консул' in text.lower(),
        'isCanceled': 'отмен' in text.lower()
    }
该算法成功将杂乱无章的原始PDF单元格字符串梳理为强类型的整洁数据:
- 准确剥离教室编号,并在渲染发生粘连时从课程名称中精准切除。
- 提取教师姓名;在无首字母缩写的情况下,激活俄语姓氏后缀(
-ova、-skiy、-in、-ev)的智能推断。 - 调用
remove_duplicate_words消除重复字符与排版噪音。 - 将课程打上一组完备的语义布尔标志(
isLecture、isPractice、isExam、isDistance、isConsultation、isCanceled、isIssusing),使得客户端UI能据此高亮渲染差异化徽标与状态色。
新架构坚不可摧。服务在几天内全面满血复活,而在学年结束时,平台指标飙升至 300个注册账户、200名稳定DAU以及突破1000名的月活跃用户(MAU)。
7. 产品减负:断舍离论坛与打造“学习”核心枢纽
2026年8月,在迎接新学年之前,我们对整个产品进行了客观冷静的复盘审计。首当其冲被放上手术台的,正是我们投入无数心血的封闭学生论坛。
从软件工程实现与设计完整度来看,论坛无疑是一个优秀的作品:精湛的界面排版、嵌套树状评论、声望徽章体系、严格防刷冷却与企业邮箱实名校验。然而从真实生活角度来看,它几乎沦为一座死城:整整一学年下来,有效讨论帖仅有数十篇。
经过深度归因,我们找出了四个致命因素:
- 目标客群性格特质: 计算机专业聚集了相当比例性格内敛的学生,对于在非主流独立站点公开公开发言存在天然的抗拒感。学院管理层甚至不得不经常举办专项活动来引导学生破冰社交。
- 成年初期的高压生活: 大一和大二新生面临着巨大的心理调适压力:应付高密度的考试周、适应严苛的大学教授、初次步入自立生活,根本无暇在一个新论坛上撰写长篇大论。
- 不可动摇的Telegram使用惯性: 每个年级、专业和小组都有着数年来早已沉淀下来的Telegram班级群。指望他们转移阵地是完全脱离现实的空想。
- “查完即走”的工具属性: 学生打开课表仅仅停留5到10秒钟:上课前快速扫一眼教室编号,随手把手机揣回兜里。没有任何人会在查课表工具里消磨时间去刷论坛长贴。
为了一个已证实没有生命力的模块背负臃肿的遗留代码包是严重的工程倒退。2026年8月27日,在一个提交中,我们一次性删除了75个文件和4497行论坛代码。
亲手抹去倾注数周心血的代码固然令人惋惜,但这正是技术心智成熟的必经之路:优秀的工程师必须敢于舍弃那些无法给真实用户带来价值的代码。
“学习”中心(/study)的涅槃
清空后的中央黄金导航位,由一个全新的、专注于直面学生刚需的学术功能中心所接替:
- 实时空闲教室雷达(
/classrooms): 一键式交互工具,直观列出当前节次或指定日期全天未排课的教室。界面清晰归纳了可用房间与占用状态,支持将常用自习教室置顶收藏。当遇上全校自习室满员的高峰期,界面还会风趣地弹出自嘲文案:“教室全无,望君保重——除却希望,尽皆客满”;而在空旷楼层则显示:“教室自助餐——座位甚至多于学生”。 - 智能导引与悬浮解析(
ClassroomTooltip与 2GIS联动):- 课表中并非所有教学都在常规编号教室进行,常出现长文本场地标记(如“阅览室A”、“大礼堂”、“体育场馆”或“学生电脑中心”)。移动端紧凑卡片无法直接容纳长句,界面将其优雅收敛为精致胶囊(如
ЧЗ-А)与主题图标。轻触卡片,ClassroomTooltip会以浮层形式完整还原其实体全称(“A座阅览室”、“学生计算机所”、“体育运动馆”、“主楼礼堂”、“线上远程教学”)。 - 一旦课程排在大学本部校区(如主楼/理科大楼),卡片将点亮醒目的高亮跳转徽标,一键呼起2GIS数字地图(
MapNsuLecture),精准锚定大学城所在大楼,消除新生因跨校区赶课而产生的迷路恐慌。
- 课表中并非所有教学都在常规编号教室进行,常出现长文本场地标记(如“阅览室A”、“大礼堂”、“体育场馆”或“学生电脑中心”)。移动端紧凑卡片无法直接容纳长句,界面将其优雅收敛为精致胶囊(如
- 课表溯源抽屉(Verify Schedule Sheet): 学生难免偶生疑虑:“万一应用更新滞后了呢?万一停课未被捕获呢?”。为此我们在课表卡片中内置了快速核对弹层。只需轻点一下,便可直接打开教务处原始PDF源文档或直通官网查验。
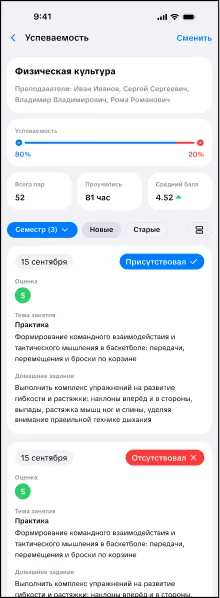
- “平时成绩单(/journal)”与“电子结业成绩册(/grade)”双线贯通: 通过会话级安全协议深度对接新西伯利亚国立大学统一认证门户(
cab.nsu.ru):- 日常过程考勤簿: 紧跟学期每周动态节奏——家庭作业布置、阶段性课业主题、考勤缺卡记录(“H”标识)以及测验与考查周成绩变动。
- 官方毕业考核册: 完整提取横跨整个大学学业周期的期末考试正式评级。异步提取函数
grade(self)能解析出学籍编号、所修专业、科目成绩与评定教师,并自动推导加权总均分与毕业投影绩点:
async def grade(self):
    try:
        headers = {
            'Cookie': self.cookie,
            'X-Requested-With': 'XMLHttpRequest',
            'Referer': 'https://cab.nsu.ru/student/grade'
        }
        async with self.session.get('/student/grade?load-widget=true', headers=headers) as r:
            if len(r.history) != 0 or r.status == 403:
                return None

            soup = BS(await r.text(), 'html.parser')
            header = soup.find('div', class_='block-header')
            if not header:
                return None

            number = ''
            specialty = ''
            for title in header.find_all('h4', class_='block-header-title'):
                title_text = title.text.strip()
                if 'Номер:' in title_text:
                    number = title_text.replace('Номер:', '').strip()
                elif 'Специальность:' in title_text:
                    specialty = title_text.replace('Специальность:', '').strip()

            average_rating = ''
            diploma_rating = ''
            for store_block in header.find_all('div', class_='average-store'):
                store_title = store_block.find('div', class_='title')
                store_val = store_block.find('div', class_='store')
                if store_title and store_val:
                    st_text = store_title.text.strip()
                    if 'Общий средний балл' in st_text:
                        average_rating = store_val.text.strip()
                    elif 'Средний балл диплома' in st_text:
                        diploma_rating = store_val.text.strip()

            terms = []
            tab_panes = soup.find_all('div', class_='tab-pane')
            for pane in tab_panes:
                pane_header = pane.find('h4', class_='block-header-title')
                pane_title = pane_header.text.strip().replace('Успеваемость за ', '').strip() if pane_header else pane.get('id', '')

                subjects = []
                for item in pane.find_all('div', class_='item-grade'):
                    name_el = item.find('div', class_='name')
                    name = name_el.text.strip() if name_el else ''

                    mark_el = item.find('span', class_='mark')
                    mark = mark_el.text.strip() if mark_el else ''
                    mark_classes = mark_el.get('class', []) if mark_el else []
                    mark_type = next((c for c in mark_classes if c != 'mark'), '')

                    kurs_el = item.find('div', class_='kurs')
                    date = kurs_el.text.replace('Дата:', '').strip() if kurs_el else ''

                    isp_el = item.find('div', class_='isp')
                    attestation_type = isp_el.text.replace('Форма аттестации:', '').strip() if isp_el else ''

                    teacher_el = item.find('div', class_='teachers')
                    teacher = ''
                    if teacher_el:
                        teacher_span = teacher_el.find('span')
                        if teacher_span:
                            teacher = teacher_span.text.strip()
                        else:
                            teacher = teacher_el.text.replace('Преподаватель:', '').strip()

                    subjects.append({
                        'name': name,
                        'mark': mark,
                        'mark_type': mark_type,
                        'date': date,
                        'type': attestation_type,
                        'teacher': teacher
                    })

                terms.append({
                    'title': pane_title,
                    'subjects': subjects
                })

            return {
                'number': number,
                'specialty': specialty,
                'average_rating': average_rating,
                'diploma_rating': diploma_rating,
                'terms': terms
            }
    except Exception:
return None-
官方行政通报公示(
/orders)与下课作息作息表(/bells): 为了一站式解决校园所有公文与时间查询,我们对学院官网发布的文件通告(录取名单、助学金核准、转专业异动与学籍更替)实现了结构化解析,并将早晚两班的完整上下课钟声表收录离线备查。学生再也不必穿梭于楼道墙角查看陈旧打印纸——节次起始精确到秒,离线触手可及。 -
成绩变动后台守卫守护进程(
NsuMarksNotify): 异步守护进程每隔30分钟静默巡检已订阅学生的学术成绩。当通过_detect_new_marks捕获到全新评分注入时,服务器瞬间点对点下发系统级Web Push。学生们常常能在手机锁屏上率先获悉考分,甚至早于任课老师在讲台上当众宣读的时间点:
changes = self._detect_new_marks(old_term, new_term)
if changes:
    for change in changes:
        title = f'Новая оценка по {change['subject']}'
        text = f'В журнал добавлена оценка {change['mark']} по предмету {change['subject']}. Проверьте детали в приложении.'
        Util.sendWebPush(Util.buildSubscriptionInfo(user), {'title': title}, text)
        await NsuNotificationManager.create(
            user=user,
            notify_type='new_mark',
            title=title,
            message=text,
            data={'subject': change['subject'], 'mark': change['mark']}
        )
至此,在应用内部构建起了一个集课堂表现、考试成绩与学业欠费状态于一体的完整数字化生态闭环。
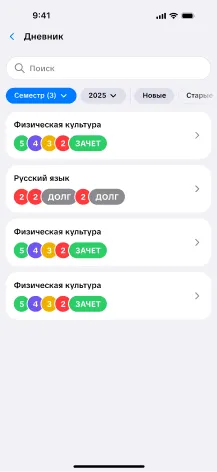
学生在详细学业页中能够随时洞悉平均绩点、考勤出勤率与各学期成绩明细。
8. 总结与工程反思
截至2026年9月,这个服务依旧是一个完全独立的非官方产物。学院管理层大概率永远不会将其收编为官方软件,但客观上也绝无这种必要。当官方排课网站仍在由于网络超时而瘫倒时,我们的PWA每天早晨如期在数百名学子与任课讲师的掌中点亮。它早已超越了普通的查课工具:学院讲师在其中核对自己的课时排期与课间空档,各班班长利用它锁定自习空教室以开展期末答疑与集体辅导。
最终技术栈清单
| 领域 | 技术方案 |
|---|---|
| Frontend | React 19, TypeScript, Vite, PWA (vite-plugin-pwa, Cache Storage), Capacitor, Redux Toolkit, React Router 7, SCSS Modules, Tabler Icons |
| Backend | Python, FastAPI, Uvicorn, Tortoise ORM, PostgreSQL (asyncpg), Pydantic v2 |
| Parsing & PDF | Camelot (lattice, OpenCV), PyMuPDF, Pandas, BeautifulSoup4 |
| Infrastructure | Linux VPS, Nginx (SSL Let’s Encrypt, HTTP/2, Gzip), Web Push (VAPID) |
回望这一年半以来经历的无数次推倒重来、技术破局与挑灯夜战,我提炼出了三条最核心的软件工程准则:
- 盲目AI写代码(Vibe-Coding)仅适用于快速验证想法的最初火花。 用它在深夜快速拼装原型是极好的。但若是把未经透彻理解的代码带进生产环境,就是为未来亲手埋下一颗致命的架构炸弹。真正的系统稳定性,只有在你彻底吃透
line_scale、joint_tol、Service Worker完整生命周期以及网络会话机制之后才会真正降临。 - 懂得删除代码的能力,远比懂得写代码更重要。 亲手把熬夜几周写就的数千行论坛代码全部粉碎是痛苦的。但唯有坚定地砍去这4500行死代码,才让这个工具彻底摆脱了臃肿冗杂的枷锁,蜕变回一款极致迅捷、聚焦痛点并受人信赖的纯粹利器。永远要热爱用户问题的解决本身,而不是迷恋自己写下的代码行数。
- PWA是独立开发者无可替代的战略级超级武器。 摆脱每年99美元的开发者保护费勒索、规避繁琐官僚的应用商店审查、享受按秒计算的静默热推,并带给用户毫无妥协的离线使用体验——这一切使得开放的现代Web成为了赋能本地社群最纯粹的数字乐土。
真正的软件工程从不盲从稍纵即逝的营销概念。它关乎你有无勇气直面一份糟糕陈旧、极难处理的PDF文件,并坚定不移地将其打磨成每天早晨让身边真实人群生活变得更顺心一点的数字工具。
在此特别鸣谢设计师 Arlen 奠定的视觉设计风格,感谢他对无数次设计迭代的包容与对该项目自始至终的坚定信心。