工程案例:Discord机器人架构从单体到热重载集群的演进之路
工程案例:Discord机器人架构从单体到热重载集群的演进之路
在只有十几个测试服务器的玩具项目中开发Discord机器人似乎轻而易举:翻阅discord.js文档,挂载interactionCreate监听器,编写几条斜杠命令,然后将其挂在后台运行即可。
然而,一旦涉足真实的高并发生产环境,工程复杂性便呈现指数级攀升。当机器人跨越数千个社区与数百万活跃用户的门槛时,开发者将直面分布式系统的全套硬核挑战:
- WebSocket网关流量雪崩(Discord Gateway):每秒涌入数千个JSON数据包,Node.js运行时必须在不阻塞事件循环(Event Loop)的前提下完成高速反序列化。
- V8堆内存灾难性膨胀(Cache Bloat):
discord.js的默认数据结构会贪婪地将遇到的每个用户、频道、身份组和消息全量缓存至内存,迅速逼近Node.js内存上限。 - 特权网关意图受限(Privileged Gateway Intents):Discord API对读取服务器成员名单(
GUILD_MEMBERS)与消息正文(MESSAGE_CONTENT)设置了严苛限制,倒逼系统必须构建非阻塞的延迟按需拉取机制(Lazy Fetching)。 - 数据库连接池耗尽:对每次聊天事件直接查询数据库(MySQL/MongoDB)会瞬间击垮关系型连接池并耗尽磁盘I/O。
- 工单支持系统的高可用陷阱:单体机器人在滚动重启或遭遇故障时,如果技术支持与工单模块内置于同一进程中,整个官方服务器将彻底瘫痪,用户在最需要救助时无法创建任何工单。
本文将按时间顺序深入复盘三代核心架构的演进脉络:Desires、Niako 以及 Rushia & Osaka。我们将完整剖析从早期JavaScript单体架构,蜕变至实现零停机热代码动态替换的分布式WebSocket集群的工程全貌。
1. Desires时代:Vanilla JS单体架构与15,000个服务器
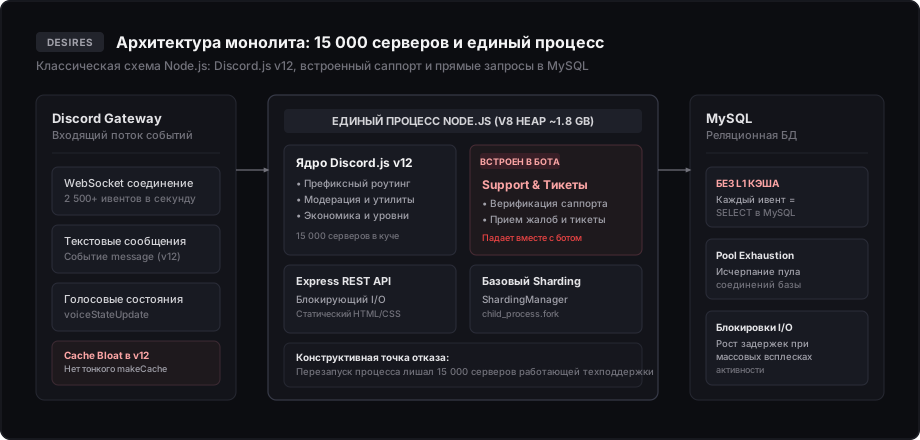
Desires是整个机器人体系中首个大规模实战试金石。在其巅峰时期,机器人服务于15,000个服务器及超过350万活跃用户,全权负责自动化管理、娱乐互动、虚拟经济与社区治理。
技术栈与初始架构背景
Desires采用了早期Node.js生态的标准单体设计:
- 核心运行时:原生JavaScript(Vanilla JS),
discord.js v12库(彼时尚未出现细粒度的makeCache内存配额机制,斜杠命令亦未正式普及)。 - 交互模型:基于
message事件的传统文本前缀指令,依赖全量字符串匹配与解析。 - API与网页端:基于Express搭建的独立微服务,承载轻量静态网页(HTML/CSS),后续曾基于Vue + Nuxt进行二代后台原型设计。
- 数据库:MySQL,直接在事件监听器中发起原生SQL查询,完全没有内存缓存层。
- 分片体系:
discord.js内置的基础ShardingManager,通过child_process.fork派生子工作进程。
单体架构的严峻挑战
虽然Desires性能稳定且长期经受住了高流量考验,但作为典型的早期单体设计,其深层架构权衡在规模扩大后逐渐暴露:
-
内置支持链路成为致命单点故障: 官方技术支持服务器的所有自动化功能(工单受理、自动身份组分发、入群验证)全部直接耦合在Desires主机器人的代码库中。当公网15,000个服务器遭遇突发流量或机器人因配置更新执行日常重启时,官方支持服务器彻底丧失自动化能力。前来反馈问题的用户面对的只有毫无响应的工单按钮。
-
discord.js v12下失控的内存膨胀(Cache Bloat): 在
discord.js v12时代,尚未引入按需限制内存的Options.cacheWithLimits配置(该特性直至v13才提供)。客户端默认会将经过的每个成员、表情、消息与频道完整驻留于V8堆内存中。粗糙的消息清理器无法遏制跨15,000个服务器带来的成员数据暴增,单个工作进程的内存常年逼近1.8–2.0 GB上限,频繁触发V8垃圾回收器的长时间全停顿(Stop-the-World GC)。 -
缺乏L1缓存导致MySQL连接池瘫痪: 每次事件处理均触发直接SQL查询(
SELECT ... WHERE guild_id = ?)。在每秒数千条消息的峰值冲刷下,MySQL连接池瞬间饱和,导致工作线程严重排队并产生雪崩式响应延迟。
Desires留下了最深刻的架构警示:高并发机器人决不能构建为紧耦合单体,关键的技术支持设施必须彻底隔离至独立的自治运行环境中。
2. Niako时代:强类型TypeScript、L1/L2双层缓存与Eral独立隔离
Niako项目是针对Desires历史痛点展开的全面架构重构。该项目承载了10,000个服务器与250万用户,全面倒向强类型与模块化工程体系。
Niako核心技术栈革新
- 语言:全面迁移至TypeScript,实施严格的接口契约校验。
- 分片方案:采用
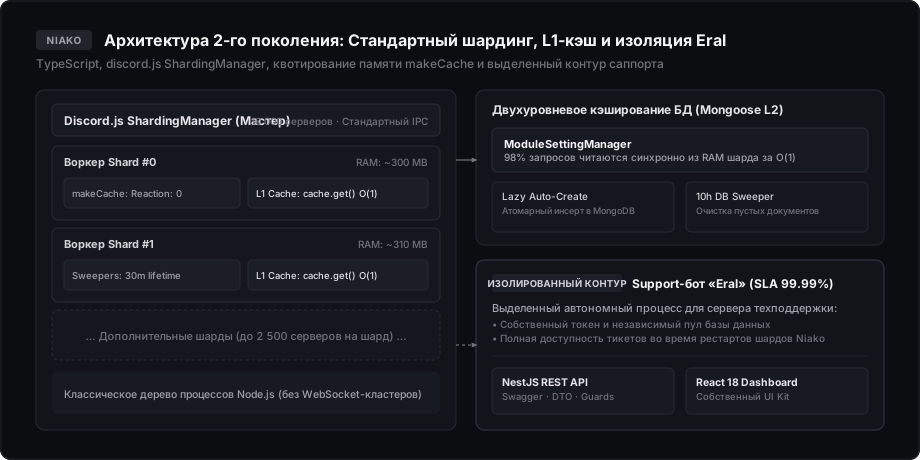
discord.js官方标准的ShardingManager(未引入复杂的WebSocket集群,依靠经典Node.js进程树调度)。 - 独立支持机器人Eral:生态内首次将技术支持业务剥离为独立部署的自治机器人。
- 后端与控制面板:基于NestJS构建完备的REST API与Swagger文档,控制面板基于React 18与自研定制UI Kit打造。
支持链路隔离:Eral机器人的诞生
Niako最核心的战略决策在于打造了Eral——一个专门服务于官方技术支持社区的轻量级自治机器人。
- Eral作为独立进程运行,拥有专属的Bot Token与独立的数据库连接池。
- Eral不加入任何外部公网服务器,彻底免疫外界不可控的流量风暴。
- 官方工单系统与权限验证的可用性达到99.99% SLA:即使Niako主集群全量重启或进行版本迭代,支持团队也能不受干扰地持续受理用户请求。
内存驯服:makeCache配额与激进Sweeper回收
Niako首次通过makeCache配置实施严格的内存配额治理,彻底关闭所有非核心业务实体:
makeCache: Options.cacheWithLimits({
    ...Options.DefaultMakeCacheSettings,
    MessageManager: {
        maxSize: 50,
        keepOverLimit: message => message.author.id === this.user.id
    },
    ReactionManager: 0,
    ReactionUserManager: 0,
    AutoModerationRuleManager: 0,
    ApplicationCommandManager: 0,
    StageInstanceManager: 0,
    VoiceStateManager: {
        maxSize: 100,
        keepOverLimit: state => !state?.mute
    },
    GuildMemberManager: {
        maxSize: 100,
        keepOverLimit: member => member.user.bot || member.permissions.has('Administrator')
    },
    PresenceManager: {
        keepOverLimit: presence => !['invisible', 'offline'].includes(presence.status) && !presence?.member?.user?.bot
    },
    ThreadManager: {
        maxSize: 100,
        keepOverLimit: thread => thread.type === ChannelType.PrivateThread
    }
}),
sweepers: {
    ...Options.DefaultSweeperSettings,
    messages: {
        interval: 1_800,
        lifetime: 1_800
    },
    guildMembers: {
        interval: 1_800,
        filter: () => member => 1 >= member.roles.cache.size
    },
    users: {
        interval: 1_800,
        filter: () => user => user.id !== user.client.user.id
    }
}
通过将ReactionManager、自动审核等管理器归零,并限制成员保留谓词,单分片工作进程的RAM占用从1.8 GB骤降至稳定的280–320 MB,彻底规避了内存溢出崩盘。
双层数据库缓存(Mongoose L2 + 内存L1)
为避免MongoDB遭受数千次重复只读请求的冲击,各个业务子系统(ModuleSettingManager、ModuleTrackerManager、ModuleRatingManager)构建了双层缓存架构:
export default class ModuleSettingManager {
    private cache: Collection<string, TModuleSetting> = new Collection()

    constructor(private db: Database) {
        setInterval(() => this.sweeper(), 36_000_000)
    }

    async get(guild: Guild, options: { fetch?: boolean } = { fetch: true }) {
        if (this.cache.has(guild.id)) {
            return this.cache.get(guild.id)!
        }
        return !options.fetch ? null : (await this.find(guild.id))
    }

    async find(guildId: string) {
        const doc = await ModuleSettingSchema.findOne({ guildId })
        if (doc) {
            this.cache.set(guildId, doc)
            return doc
        }
        return await this.create(guildId)
    }

    async save(doc: TModuleSetting) {
        const saved = await doc.save()
        this.cache.set(saved.guildId, saved)
        return saved
    }

    private async sweeper() {
        const emptyDocs = await ModuleSettingSchema.find({ isDefault: true })
        for (const doc of emptyDocs) {
            if (!this.cache.has(doc.guildId)) {
                await doc.deleteOne()
            }
        }
    }
}方案核心优势:
- 同步O(1)响应:98%的配置读取直接命中分片本地内存
Collection,无需等待网络I/O。 - 延迟自动创建(Lazy Auto-Create):当新服务器首次执行指令时,系统原子化创建默认配置并写入本地缓存。
- 10小时后台定时清理:后台巡检定期剔除数据库中长期未变更且处于默认状态的冗余文档,确保MongoDB体积精简。
3. Rushia与Osaka时代:工程美学的集大成之作
Rushia项目(原计划为NiakoV2分支)凝结了此前沉淀的全部架构精髓,成为整个平台技术成熟度最高的迭代之作。
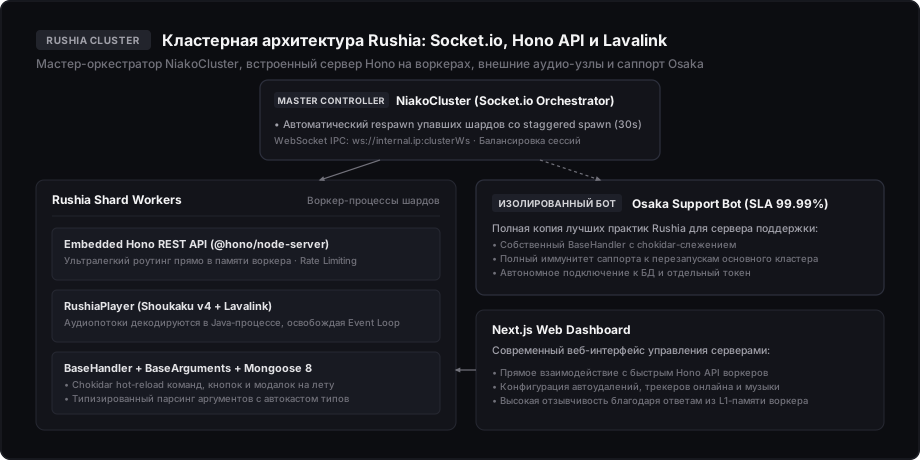
1. 迁移至进程内高速Hono API
尽管Niako中的NestJS表现稳健,但在机器人工作进程与网页后台通信时,对极致吞吐与极低内存开销提出了更高要求。Rushia全面转向Hono(@hono/node-server):
- 嵌入式REST API直接常驻于每个工作进程内部。
- 基于RegExp树的高性能路由器大幅领先Express与NestJS,内存占用几近于零。
- 内置中间件(
hono-rate-limiter与参数校验器)为来自Next.js前端控制面板的高频交互提供坚固防线。
2. 基于Socket.io的NiakoCluster跨进程WebSocket集群
由于Discord限制单个WebSocket分片仅能容纳2,500个服务器,大规模多节点集群必须依赖集中编排。Rushia研发了专用的NiakoCluster主控制器:
- 主控节点与所有分片工作节点保持基于
Socket.io的长连接WebSocket通信。 - 任何工作进程崩溃或卡死时,主控节点触发
respawn恢复指令。 - 引入错峰启动机制(Staggered Spawn):为非0号分片设置30秒平滑递延,严格遵守Discord全局每5秒仅允许发起一次
IDENTIFY的限流壁垒:
export default class WebSocketManager {
    public readonly url: string = `ws://${internal.originalIp}:${internal.ports.clusterWs}`
    public readonly shardUrl: string = `ws://${internal.ip}:${internal.ports.shardWs}`

    constructor() {
        if (!debug) {
            this.socket.emit('process')
            this.socket.on('respawn', (res: ResponseShardRespawn) => {
                this.respawn(res)
            })
        }
    }

    private async respawn(res: ResponseShardRespawn) {
        if (this.shardManager) {
            this.shardManager.shards.forEach(c => c.kill())
            this.shardManager.isRespawn = true
            delete this.shardManager
        }

        this.shardManager = new ShardingManager(res)
        this.sendCluster(res)

        if (!res.shardList.includes(0)) {
            await new Promise((resolve) => setTimeout(resolve, 30_000))
        }

        return this.shardManager.generateShards()
    }
}
3. BaseHandler革新:零停机代码热重载机制
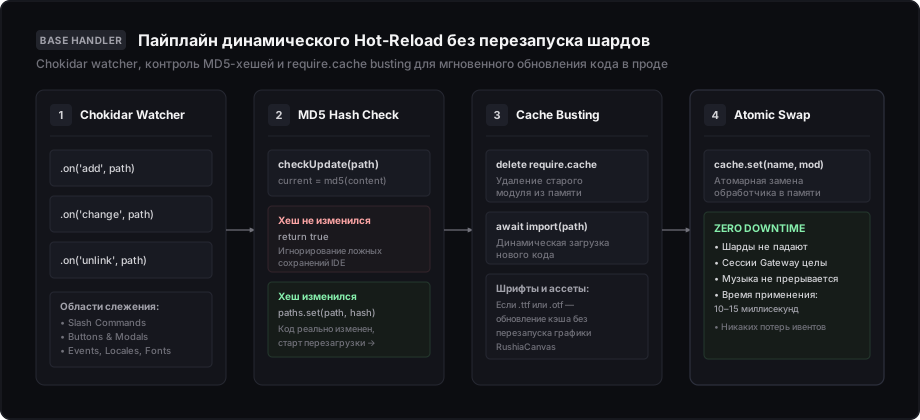
架构层最具创新性的突破莫过于BaseHandler——一个基于chokidar文件监听器构建的统一动态模块加载器。
生产运维痛点
在传统机器人体系中,每当需要修复文本错别字或调整指令逻辑时,都不得不全量重启进程。重启不仅会粗暴切断所有分片与Discord网关的活跃会话,导致数千个语音频道瞬间静音,还会引发网关重连同步风暴(Resync Storm)。
架构破局方案
BaseHandler实时监听文件系统变更,通过md5校验内容哈希差异,并运用delete require.cache对Node.js运行时缓存实施精准爆破:
import { IBaseModule } from '#types/base/BaseHandler';
import { RushiaClient } from '../client/RushiaClient';
import { readFileSync, readdirSync } from 'fs';
import { Collection } from 'discord.js';
import chokidar from 'chokidar';
import md5 from 'md5';

export default class BaseHandler {
    public readonly paths: Collection<string, string> = new Collection()
    public readonly cache: Collection<string, any> = new Collection()

    constructor(
        public client: RushiaClient,
        public directory: string,
        private options?: { usePathNames: boolean }
    ) {}

    public async loadAll(directory = this.directory) {
        const commons = readdirSync(directory)
        const directorys = this.getDirectorys(commons)
        const files = this.getFiles(commons)

        for (let i = 0; directorys.length > i; i++) {
            await this.loadAll(`${directory}/${directorys[i]}`)
        }

        for (let i = 0; files.length > i; i++) {
            await this.load(directory, files[i])
        }
    }

    public async load(directory: string, file: string) {
        const path = `${directory}/${file}`

        if (['ttf', 'otf'].some((f) => file.endsWith(f))) {
            this.chokidar(directory, file)
            return this.cache.set(path, file)
        }

        delete require.cache[require.resolve(path)]

        const module = (await import(path))?.default as IBaseModule
        if (!['object', 'function'].includes(typeof module)) return

        this.paths.set(path, md5(readFileSync(path).toString('utf-8')))

        switch (typeof module) {
            case 'object':
                if (module?.options?.disabled) return
                if (!module?.options) {
                    return this.cache.set(file.split('.')[0], module)
                }
                module.options.dir = directory
                this.chokidar(directory, file)
                return this.cache.set(this?.options?.usePathNames ? path : (module.options?.name || path), module)
            case 'function':
                const pull = new (module as any)()
                if (!pull?.options || pull?.options?.disabled) return
                pull.options.dir = directory
                this.chokidar(directory, file)
                return this.cache.set(this?.options?.usePathNames ? path : (pull.options?.name || path), pull)
        }
    }

    private chokidar(dir: string, file: string) {
        const path = `${dir}/${file}`
        chokidar.watch(path).on('add', path => {
            if (this.checkUpdate(path)) return
            this.load(dir, file)
        }).on('change', path => {
            if (this.checkUpdate(path)) return
            this.load(dir, file)
        }).on('unlink', path => {
            if (this.checkUpdate(path)) return
            this.load(dir, file)
        })
    }

    private checkUpdate(path: string) {
        const current = md5(readFileSync(path).toString('utf-8'))
        if (current !== this.paths.get(path)) {
            this.paths.set(path, current)
            return false
        } else {
            return true
        }
    }
}
流水线运行机制详解:
- MD5哈希防抖保护:操作系统在IDE保存文件时往往会接连抛出多次
change事件。checkUpdate(path)计算文件当前哈希并与this.paths中的历史记录比对,若哈希一致则立即忽略。 - 运行时require.cache擦除:通过
delete require.cache[require.resolve(path)]清除Node.js模块缓存池中的陈旧编译产物。 - 原子级重新导入:执行
await import(path)装载全新逻辑,并将新指令或交互组件原子化更新至this.cache中。 - Canvas动态字体支持:对
.ttf或.otf字体变更自动热注入,保障个人资料卡片渲染引擎无需重启。
最终成效:任何指令修改、交互按钮行为变更或多语言文案更新,均可在10–15毫秒内无感生效于生产环境,分片零崩溃,连接零断开!
4. 强类型AST参数解析器:BaseArguments
针对传统前缀指令,系统研发了继承自原生Array的强类型参数解析器:
- 自动将用户提及、数字ID和昵称解析为规范的
GuildMember对象。 - 将频道、身份组、十六进制颜色值以及时间跨度字符串(通过
ms解析,如"1d"、"2h"、"30m")自动强转为规范数据类型。 - 在指令
run()执行前完成严密的前置校验。
5. 音频子系统:基于Shoukaku v4与Lavalink的RushiaPlayer
实时音频推流因需要频繁进行Opus数据包编解码,是Node.js运行时的头号计算瓶颈。
- Rushia将全部音频逻辑解耦至基于Shoukaku v4封装的RushiaPlayer中。
- 音频流渲染完全托付给外部独立的Java Lavalink节点集群处理。
- Node.js主事件循环仅负责传递轻量WebSocket控制指令,彻底免除了音频处理开销。
6. 独立支持机器人Osaka
秉承Niako/Eral的成功经验,Rushia官方技术支持服务器配备了专属机器人Osaka。其完整继承了BaseHandler动态热重载与模块化架构,在独立运行环境与专属数据库加持下,确保了100%的稳定度。
4. 三代核心架构横向演进对比
| 核心维度 | 1. Desires | 2. Niako | 3. Rushia & Osaka |
|---|---|---|---|
| 承载规模(用户 / 服务器) | 350万 / 15,000 | 250万 / 10,000 | 准发布级集群 |
| 开发语言 | JavaScript (Vanilla JS) | TypeScript (Strict) | TypeScript (Strict, ESM/CJS) |
| Discord核心库 | Discord.js v12 (文本前缀指令) | Discord.js v14 (斜杠指令) | Discord.js v14 (斜杠 + 上下文菜单) |
| 分片调度方案 | 基础ShardingManager | 官方标准ShardingManager | NiakoCluster (Socket.io Master) |
| 数据缓存链路 (L1/L2) | 无L1缓存 (直接MySQL I/O) | L1本地内存 + Mongoose L2 | L1本地内存 + Mongo 8 + TTL |
| 代码热更新机制 | 全量重启主进程 | 重启指定分片 | BaseHandler动态热重载 (chokidar) |
| 服务级REST API | Express | NestJS + Swagger文档 | 嵌入式Hono (@hono/node-server) |
| 网页控制面板 | HTML/CSS (v2原型: Vue/Nuxt) | React 18 + 自研定制UI Kit | Next.js + 自研定制UI Kit |
| 技术支持体系 (Support) | 紧耦合内置 (单体架构) | 独立隔离机器人Eral | 独立隔离机器人Osaka |
| 音频推流引擎 | — | Lavalink v3 | Shoukaku v4 + Lavalink |
5. 核心架构总结与分布式工程法则
从Desires单体架构跨越至Rushia分布式集群,整个演化历程淬炼出了构建高可用Discord机器人的6条黄金法则:
-
绝对不要将支持系统与主业务机器人耦合: 公网业务在流量洪峰下的崩溃,决不能波及技术支持与工单系统。构建自治运行的独立支持机器人(Eral、Osaka)是捍卫99.99%支持SLA的唯一正解。
-
从第一字节起严格控制内存缓存配额: 未经约束的
discord.js会全量收容所有网关实体。务必将非核心模块(ReactionManager: 0、AutoModerationRuleManager: 0)清零,并为用户与语音状态设定严苛的保留谓词(keepOverLimit)。 -
每个工作节点必须标配L1本地内存缓存: 服务器配置查询必须在内存中以$O(1)$复杂度同步决断。持久层数据库仅应承担数据写入与极少量的缓存穿透。
-
生产环境代码热重载是抵御停机震荡的利器: 借助以
chokidar为基石的BaseHandler,结合MD5增量比对与require.cache失效机制,可在毫秒级平滑打入补丁,完全保全活跃网关连接与推流会话。 -
重型计算负载必须强行外置: 高CPU开销任务(如Opus音频转码、复杂的Canvas绘图)应当全部分流至外部微服务集群(如Lavalink),释放Node.js事件循环专注保障WebSocket通信。
-
内部交互接口极致轻量化: 在工作进程内部舍弃沉重的全功能框架,全面拥抱如Hono般的超轻量路由器,以极致紧凑的内存占用换取微秒级的响应反馈。