История создания PWA расписания ВКИ НГУ: от первой строчки кода до сотен студентов каждый день
История создания PWA расписания ВКИ НГУ: от первой строчки кода до сотен студентов каждый день
В студенческой жизни есть вещи, к которым привыкаешь как к неизбежному злу. Для студентов Высшего колледжа информатики Новосибирского государственного университета (ВКИ НГУ) таким злом годами оставалось расписание пар. Учебная часть колледжа ежедневно публиковала его исключительно в виде многостраничных PDF-файлов, сверстанных вручную без какого-либо программного API.
Каждое утро сотен учащихся начиналось с одного и того же утомительного ритуала: зайти на официальный сайт, скачать тяжелый документ на смартфон, открыть просмотрщик файлов и судорожно зумить мелкую сетку двумя пальцами, выискивая номер своей группы среди десятков одинаковых ячеек. Хуже всего было то, что расписание требовалось не один раз с утра, а перед каждым звонком: узнать номер аудитории, проверить фамилию преподавателя или убедиться, что пару не перенесли в другой корпус.
Ситуацию усугубляла физическая среда: старое монументальное здание колледжа с метровыми кирпичными стенами и подвальная качалка, где в холодное время года проходят занятия по физкультуре (если они не проводятся на улице), превращались в настоящие клетки Фарадея. Мобильная связь там падала до абсолютного нуля. Если студент забыл заранее загрузить файл в память телефона, он оставался в полном информационном вакууме прямо перед закрытыми дверями кабинетов.
В этой статье я хочу подробно рассказать историю создания независимого PWA-сервиса: путь от первых наивных ночных экспериментов и фальстарта до зрелой архитектуры, инженерного выбора веб-технологий, реверс-инжиниринга таблиц и построения надежного офлайн-клиента.
1. Февральский фальстарт: Gravity UI, первый вайбкод и поворот в СПбГУПТД
История проекта зародилась 5 февраля. Ближе к полуночи в голове внезапно щелкнуло: почему студенты одного из ведущих IT-колледжей Сибири в 2025 году должны каждое утро ломать глаза об архаичные документы? Ведь вокруг кипит мир современных интерфейсов, веб-приложений и реактивных фреймворков.
Появился мощный импульс: сесть и за одну ночь собрать быстрое, удобное и современное веб-приложение расписания. В качестве дизайн-системы я выбрал Gravity UI от Яндекса. Ее компонентная база выглядела технологично, минималистично и идеально подходила под строгие таблицы, списки групп и расписания.
Я сел за макеты, набросал базовые экраны с реальными данными расписания ВКИ, начал параллельно верстать интерфейс на React и экспериментировать с бэкендом. И вот здесь я впервые угодил в ловушку слепого «вайбкодинга».
На тот момент я совершенно не являлся Python-разработчиком. Я слабо ориентировался в библиотеках экосистемы, не знал тонкостей асинхронных фреймворков и архитектуры модулей обработки документов. Казалось, что в эпоху современных нейросетей разбираться в кишках PDF вообще не требуется: достаточно скормить документ языковой модели и попросить написать парсер, который выдаст красивый JSON.
Реальность быстро и безжалостно охладила этот юношеский пыл.
PDF — это не база данных, не структурированный HTML и даже не электронная таблица. Это низкоуровневый поток инструкций для виртуального принтера: где нарисовать отрезок векторной линии по физическим координатам (x, y) и где расположить конкретный глиф шрифта. В исходном файле нет понятий «строка», «колонка» или «ячейка таблицы». Есть лишь визуальные линии и разрозненный текст, висящий в определенных координатах страницы.
Сгенерированный на скорую руку скрипт выдавал откровенную кашу:
- Объединенные ячейки потоковых лекций произвольно привязывались к случайным подгруппам.
- Сдвиги колонок на полмиллиметра ломали соответствие между временными интервалами и номерами аудиторий.
- Разнородное написание инициалов преподавателей приводило к десяткам дублирующихся фантомных записей.
Вникать в сложную математику координат и геометрию векторных примитивов посреди ночи не хотелось. Первоначальный запал угас, наступило разочарование, и проект для ВКИ лег на полку. Это стало важным жизненным уроком: невозможно успешно создавать надежную систему, если ты сам не понимаешь физику входных данных.
Однако вложенные силы не пропали даром. Вскоре поступило предложение сделать расписание для другого вуза — СПбГУПТД (sutd.okak.pw).
Контраст оказался поразительным. В отличие от ВКИ, у СПбГУПТД расписание публиковалось в виде нормально структурированных таблиц Excel (.xlsx), которые к тому же не перекраивались каждый день диспетчерской. Парсить их с помощью стандартных библиотек было одно удовольствие: строгая сеточная структура, предсказуемые ячейки и отсутствие векторного хаоса.
Тот самый дизайн на Gravity UI, изначально задуманный под ВКИ, прекрасно подошел для нового проекта. Работа над СПбГУПТД позволила мне без лишних нервов отточить базовое клиентское состояние, компонентную архитектуру, логику отображения учебных недель и взаимодействие с API. Это была отличная полигонная площадка, сохранившая фундамент для будущего возвращения к родному колледжу.
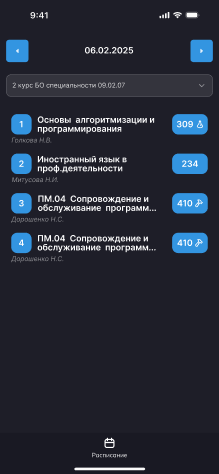
2. Попытка номер два: 18 лет, отказ от Discord-ботов и выбор PWA
К началу лета совпало сразу несколько важных жизненных факторов. Во-первых, мне исполнилось 18 лет — своеобразный психологический и личностный рубеж, заставляющий переосмыслить то, на что ты тратишь свое время. Во-вторых, наступило полное и бесповоротное выгорание от бесконечной разработки ботов для Discord.
Я годами занимался созданием ботов, инфраструктурой серверов и интеграциями. Но в какой-то момент пришло осознание, что создание очередного бота — это хождение по замкнутому кругу чужой платформы. Хотелось перешагнуть на качественно иной профессиональный уровень: создавать полноценные независимые веб-сервисы, которыми пользуются живые люди вокруг тебя в реальном мире и которые решают их насущные ежедневные задачи.
Под тот самый отмененный проект Discord-бота у меня уже был нанят знакомый дизайнер Арлен. Мы давно общались, и я заранее перевел ему небольшой дружеский задаток за будущую работу, к которой он успел сделать лишь первые наброски в Figma.
Я пришел к нему и сказал что-то в манере: «Слушай, бот отменяется, я больше не хочу его пилить. Давай лучше сделаем нормальное, стильное расписание для нашего колледжа».
Идея сразу нашла живой отклик у Арлена. Проект моментально перерос рамки заказной работы и превратился в совместный продукт на чистом энтузиазме — ради бесценного опыта, сильного кейса в портфолио и искренней помощи студентам.
Правда, на этапе дизайна нас поджидала забавная бытовая трудность. Изначально Арлен нарисовал макеты исключительно в светлой теме. Причина была сугубо практической: чтобы в Figma полноценно настроить дизайн-токены и переменные под автоматическое переключение тем, требовалась платная командная подписка. Дизайнер не видел смысла тратить на это лишние деньги ради студенческого некоммерческого проекта, поэтому темную тему позже пришлось бережно дорисовывать, сводить по контрастам и верстать вручную.
Инженерный выбор платформы: почему Progressive Web App?
Перед нами встал фундаментальный архитектурный вопрос: в каком виде доставлять продукт пользователям? Выбор платформы определял всю дальнейшую судьбу сервиса.
Идея разработки нативных мобильных приложений под iOS (Swift) и Android (Kotlin) была отброшена практически сразу по нескольким критическим причинам:
- Финансовый и санкционный барьер: ежегодная подписка Apple Developer Program стоит 99 долларов в год. В текущих реалиях оплатить ее из РФ студенту невероятно сложно. Платить такие деньги каждый год за некоммерческий сервис для своего колледжа выглядело сомнительной затеей.
- Задержка модерации (App Store Review): если учебная часть колледжа внезапно меняет разметку PDF или структуру пар, хотфикс на клиенте должен долетать за минуты. Ждать двое-трое суток, пока ревьюеры Apple проверят обновление, означало бы оставить студентов без расписания на полнедели.
- Ресурсный оверхед: поддержка двух независимых нативных кодовых баз ради утилитарного студенческого справочника требовала колоссальных временных затрат, которых у нас попросту не было.
Обычный сайт в закладках мобильного браузера тоже не решал проблему. Студенту крайне неудобно на ходу открывать браузер, искать нужную вкладку среди десятка других и ждать сетевого ответа перед запертой аудиторией.
Решением стал стандарт Progressive Web App (PWA), объединивший лучшие качества веба и нативных приложений:
- Установка на экран «Домой» в один клик: приложение устанавливается через браузер без сторов, получает собственную иконку, запускается в изолированном окне
display: standaloneбез адресной строки и выглядит неотличимо от нативной программы. - Мгновенная доставка апдейтов: свежий бандл подтягивается сервером автоматически при каждом перезапуске приложения.
- Честный Offline-First: связка Service Worker и Cache Storage гарантирует, что расписание откроется мгновенно даже в режиме полета в подвальной качалке колледжа.
В сборщике на базе Vite был подключен плагин vite-plugin-pwa со стратегией injectManifest. Это позволило полностью контролировать жизненный цикл Service Worker, совмещая предварительное кэширование статических ассетов с обработкой системных Push-уведомлений:
import { defineConfig } from "vitest/config";
import { VitePWA } from "vite-plugin-pwa";

export default defineConfig({
    plugins: [
        VitePWA({
            srcDir: 'src',
            filename: 'sw.ts',
            registerType: 'autoUpdate',
            strategies: 'injectManifest',
            manifest: {
                id: 'vki',
                name: 'ВКИ НГУ',
                short_name: 'ВКИ НГУ',
                start_url: '/?v=102',
                display: 'standalone',
                theme_color: '#007AFF',
                background_color: '#007AFF',
                icons: [
                    {
                        src: 'pwa-192x192.png',
                        sizes: '192x192',
                        type: 'image/png'
                    },
                    {
                        src: 'pwa-512x512.png',
                        sizes: '512x512',
                        type: 'image/png'
                    }
                ]
            }
        })
    ]
})
А сам файл сервис-воркера (sw.ts) получил лаконичную и функциональную реализацию:
/// <reference lib="webworker" />
import { precacheAndRoute } from "workbox-precaching";

precacheAndRoute(self.__WB_MANIFEST)

declare const self: ServiceWorkerGlobalScope

self.addEventListener('push', (event: PushEvent) => {
    const data = event.data?.json() || {}

    self.registration.showNotification(data.title || 'ВКИ НГУ', {
        body: data.body || 'Новое обновление расписания',
        icon: '/pwa-192x192.png',
        badge: '/pwa-72x72.png'
    })
})
Благодаря этой связке пользователь получал мгновенный запуск интерфейса и системные уведомления прямо в центр уведомлений операционной системы.
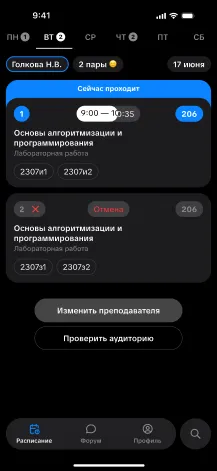
3. Архитектура первого поколения: Серверный парсер и клиентский офлайн
21 июня разработка сервиса перешла в полномасштабную активную фазу. Точка невозврата была пройдена: больше никаких отговорок и откладываний на потом. До нового учебного года оставалось чуть больше двух месяцев, и за это время требовалось создать надежный производственный конвейер.
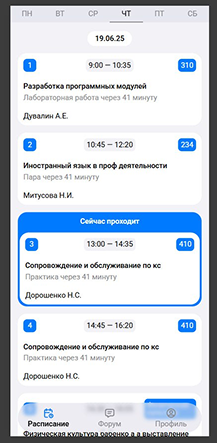
Первым делом я начал исследовать существующий ландшафт. Выяснилось, что до нас студенты уже предпринимали попытки автоматизации: существовал старый open-source проект VkiHub.
Изучение VkiHub дало мощный толчок. Его главное достоинство заключалось в понимании предметной области: в кодовой базе уже содержались базовые регулярные выражения для распознавания групп и типовых аномалий расписания колледжа. Однако взять VkiHub за основу было невозможно:
- Проект использовал тяжелый устаревший стек, требовавший чрезмерных серверных ресурсов.
- Отсутствовала какая-либо концепция PWA и мобильного офлайна.
- Архитектура была монолитной и жестко завязанной на старые соглашения, не позволяя динамически масштабировать клиентские функции.
Было принято решение писать бэкенд с чистого листа на современном стеке: FastAPI + Uvicorn + PyMuPDF + Camelot.
Анатомия парсера первого поколения
Бэкенд должен был решать главную задачу: регулярно проверять сайт колледжа, скачивать свежие PDF-файлы расписания, детерминированно извлекать из них сетку пар и формировать чистый структурированный JSON.
Для парсинга таблиц была выбрана библиотека Camelot. Чтобы ускорить обработку страниц и не зависеть от тяжелых внешних утилит, мы написали собственный легковесный бэкенд конвертации ConversionBackend на базе высокоскоростной библиотеки pymupdf. Он на лету рендерил страницы PDF в растровые изображения с плотностью 120 DPI для морфологического анализа линий:
class ConversionBackend:
    def convert(self, pdf_path, png_path):
        pymupdf.Document(pdf_path)[0].get_pixmap(dpi=120).save(png_path)

class Parser:
    def __init__(self):
        self.conversion_backend = ConversionBackend()

    def extract_teacher_name(self, content):
        teacher_match = re.findall(r'\b[А-ЯЁ][а-яё]*\s[А-ЯЁ]\.\s?[А-ЯЁ]\.?\b', content)
        teacher = teacher_match[0] if teacher_match else ''
        if content.startswith('НГУ') or content.startswith('Нгу'):
            teacher = self._get_teacher(content)

        if teacher:
            formatted_teacher = teacher + '.' if not teacher.endswith('.') else teacher
            if formatted_teacher[-3] == ' ':
                formatted_teacher = formatted_teacher[:-3] + formatted_teacher[-2:]
            return formatted_teacher, content.replace(teacher, formatted_teacher)

        return teacher, content

    def extract_classroom(self, content):
        classroom_match = re.findall(r'\b\d{3}[a-zа-яё]?\b', content)
        classroom = classroom_match[0] if classroom_match else ''

        if content.startswith('НГУ') or content.startswith('Нгу'):
            classroom = f'НГУ {classroom}'

        for special_room in ['Читальный зал', 'Актовый зал', 'Физкультура', 'Физическая культура']:
            if special_room in content:
                classroom = special_room
                break

        return classroom
Особое внимание уделялось очистке данных:
- Преподаватели: инициалы могли быть записаны как
Иванов И.И.,Иванов И. И.или вовсе без финальной точкиИванов И.И. Регулярное выражение и функция нормализации аккуратно приводили все варианты к строгому стандарту с пробелом перед фамилией и закрывающими точками. - Аудитории: помимо стандартных трехзначных номеров кабинетов (
214,308а), парсер распознавал специальные локации («Читальный зал», «Актовый зал», «Физкультура»), а также занятия, проходящие в главном корпусе университета с префиксомНГУ.
Сам запуск Camelot первого поколения опирался на сбалансированные параметры детекции:
tables = camelot.read_pdf(
    pdf_path,
    pages='all',
    copy_text=['h', 'v'],
    line_scale=55,
    joint_tol=12,
    line_tol=12,
    backend=self.conversion_backend
)

schedule = {}
for table in tables:
    data = table.df.values.tolist()
    if 'время' in data[0]:
        continue

    data = self.process_table_data(data)
    data, week_dates = self.fix_missing_data(data)

    for i in range(1, len(data)):
        row = data[i]
        for j in range(2, len(row)):
            if row[1].endswith('.5') and data[i][j] == data[i-1][j]:
                continue

            content = self.parse_lesson_content(row[j])
            teacher, content = self.extract_teacher_name(content)
            classroom = self.extract_classroom(content)
            group_name = data[0][j]
            day_name = row[0]

            if group_name not in schedule:
                schedule[group_name] = {}

            if day_name not in schedule[group_name]:
                schedule[group_name][day_name] = {
                    'date': week_dates.get(day_name, ''),
                    'lessons': []
                }

            schedule[group_name][day_name]['lessons'].append({
                'content': content,
                'number': row[1],
                'group': group_name,
                'teacher': teacher,
                'classroom': classroom,
                'cancelled': 'отмена' in row[j].lower()
            })
Обратите внимание на логику с суффиксом .5: когда учебная часть делила пару между двумя подгруппами либо распределяла занятия по четным и нечетным неделям (числитель/знаменатель), номер пары получал дробное значение, сохраняя строгую хронологию.
Клиентская архитектура и Stale-While-Revalidate
На стороне фронтенда (React + Redux Toolkit) стояла не менее важная задача: гарантировать, что приложение откроется моментально в любых сетевых условиях.
Если наивно сохранять в localStorage весь многомегабайтный JSON расписания со всеми отделениями, курсами и группами колледжа, браузер быстро упрется в лимиты памяти, а сериализация начнет ощутимо фризить главный поток рендеринга.
Мы спроектировали умный механизм избирательной синхронизации кэша syncScheduleCache в модуле util.ts:
export const syncScheduleCache = (schedule: any) => {
    if (!schedule) return
    const storage = getStorage()
    const favorites = storage.favorite || []
    const params = new URLSearchParams(`?${localStorage.getItem('params') || ''}`)
    const selected = params.get('group') || params.get('teacher') || params.get('classroom') || null

    let cache = getScheduleCache() || {}

    if (selected && schedule[selected]) {
        cache[selected] = schedule[selected]
    }
    favorites.forEach((f: string) => {
        if (schedule[f]) cache[f] = schedule[f]
    })

    for (const key of Object.keys(cache)) {
        if (key !== selected && !favorites.includes(key)) {
            delete cache[key]
        }
    }

    if (Object.keys(cache).length) setScheduleCache(cache)
    else localStorage.removeItem('ci-schedule-cache')
}
Алгоритм сохраняет исключительно то, что реально нужно конкретному студенту: текущую выбранную группу и список групп или преподавателей, добавленных в избранное. Все лишние данные автоматически отсекаются, сохраняя кэш компактным и легковесным.
Входная точка жизненного цикла приложения в App.tsx реализует классический паттерн Stale-While-Revalidate (SWR):
const cached = getScheduleCache()
if (cached) {
    this.props.setSchedule(cached)
}

const promise = fetch(`${apiUrl}/schedule`).then((r) => r.json()).catch(() => null)

const handleRes = (res: any) => {
    if (res?.ok) {
        this.props.setSchedule(res.result)
        syncScheduleCache(res.result)
    }
}

if (cached) {
    promise.then(handleRes)
} else {
    const res = await promise
    handleRes(res)
}
Как это работает на практике:
- Если студент уже открывал приложение ранее,
getScheduleCache()поднимает сохраненные пары из памяти за 0 миллисекунд. Интерфейс отрисовывается мгновенно, без спиннеров и задержек — даже если телефон находится в глубоком офлайне в подвале. - Параллельно в фоне запускается сетевой запрос к API.
- Когда сервер возвращает свежие данные, приложение тихо обновляет Redux-хранилище и актуализирует кэш в фоновом режиме, не прерывая взаимодействие пользователя с экраном.
- Если же кэша нет (первый холодный запуск), приложение дожидается сетевого ответа и плавно инициализирует интерфейс.
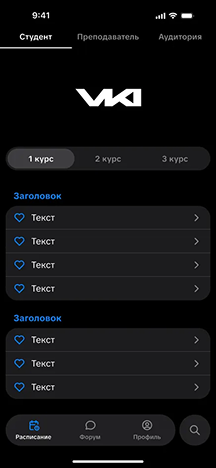
4. Разрастание экосистемы: Профиль, Web Push и закрытый студенческий форум
Когда базовый конвейер расписания доказал свою стабильность, возникло естественное желание двигаться дальше. Просто показывать статичную сетку занятий казалось слишком простым и утилитарным сценарием. Захотелось превратить проект в живую доверенную цифровую среду для всего колледжа.
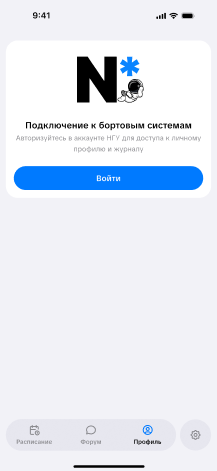
Первым фундаментальным шагом стало внедрение авторизации и личного профиля. Вопрос безопасности стоял остро: открывать регистрацию всем желающим через обычную почту или соцсети означало моментально захлебнуться в спаме, токсичности и флуде.
Мы приняли строгое инженерное решение: авторизация в профиль осуществляется исключительно через корпоративные Google-аккаунты колледжа на домене @mer.ci.nsu.ru. Это обеспечило стопроцентную верификацию:
- Внутри сообщества находились только реальные очные студенты и преподаватели колледжа.
- Пользователи отображались со своими настоящими именами и фамилиями из учетной записи учебного заведения.
- Отсекалась любая возможность накрутки аккаунтов или анонимного троллинга.
Сразу после авторизации пользователь получал возможность настроить Web Push уведомления через протокол VAPID (pywebpush). Сервер генерировал уникальную криптографическую подписку браузера, сохранял ее в базе данных и связывал с профилем учащегося.
Особого внимания заслуживала архитектура отправки уведомлений о новом расписании. Учебная часть никогда не выкладывала все документы одновременно: файлы публиковались на сайте частями в течение всего вечера — один курс в 18:00, второй в 19:30, третий ближе к 22:00. Если бы бэкенд ждал полной выгрузки всех курсов, студенты получали бы уведомления глубокой ночью. Если бы спамил всех подряд при появлении каждого нового файла — это вызывало бы волну раздражения и отписок.
Мы разработали алгоритм таргетированных микропушей: воркер сопоставляет обновленные группы и преподавателей с индивидуальными подписками пользователей и моментально отправляет системный пуш Обновилось расписание для группы 2307и1 ровно в ту минуту, когда распарсился именно их PDF-файл. А общее уведомление по колледжу уходит только тогда, когда день выгружен целиком (is_complete).
Закрытый студенческий форум
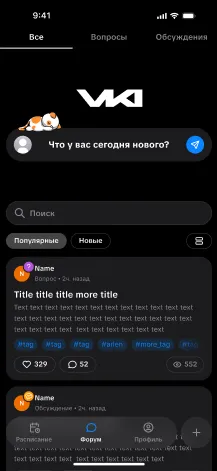
Следом за профилем родилась самая масштабная идея лета — построить прямо внутри PWA закрытый студенческий форум. Мы подошли к задаче со всей серьезностью взрослой социальной платформы:
- Два целевых формата публикаций:
- «Вопросы» — специализированный раздел для тех, кому нужна помощь с домашними заданиями, лабораторными работами или курсовыми проектами.
- «Обсуждения» — свободная площадка для студенческих инициатив, поиска тиммейтов на хакатоны и неформального общения.
- Интерактивные цветовые теги: возможность категоризировать топики по предметам («Программирование», «Математика», «Сети») и мгновенно фильтровать ленту по клику на тег.
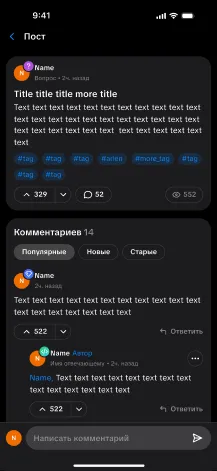
- Древовидная система комментариев: полноценные ветки ответов с мгновенной отправкой системных Web Push автору темы при появлении новых сообщений.
- Игрофикация и признание: визуальные SVG-бейджи на аватарках пользователей — отметка разработчика (
badge_dev), дизайнера (badge_design), участников закрытого бета-теста (badge_beta), а также публичные счетчики просмотров и реакций. - Алгоритмическое ранжирование ленты: мы внедрили формулу популярности публикаций
Score = Likes * 3 + Views, которая поднимала полезные и обсуждаемые вопросы на самый верх списка, опуская неактивные темы вниз. - Серверная защита от флуда: жесткий 15-минутный кулдаун между созданием новых публикаций. При попытке опубликовать второй пост раньше времени бэкенд возвращал статус HTTP 429 со счетчиком секунд, оставшихся до разблокировки формы.
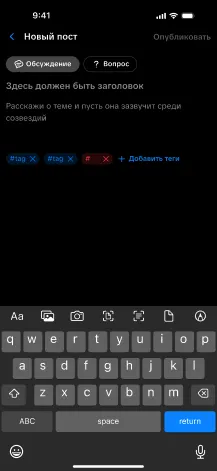
Интерфейс создания публикаций Арлен сделал предельно лаконичным: выбор типа поста, ввод заголовка, тела сообщения и интерактивный селектор тегов.
В карточке просмотра публикации разворачивалась полноценная лента дискуссии с бейджами ролей и древовидными ответами.
5. Августовский запуск в прод: Столкновение с реальностью и неучтенный 4 курс
К концу августа 2025 года сервис был полностью собран, протестирован локально и готов к боевому выходу. Мы арендовали надежный VDS под управлением Linux, настроили Nginx в качестве реверс-прокси, установили бесплатные SSL-сертификаты от Let’s Encrypt и выкатили первую публичную версию PWA.
Мы чувствовали себя победителями: дизайн выверен, оффлайн протестирован в авиарежиме, форум работает, пуши долетают. Оставалось дождаться начала учебы.
И вот наступило 1 сентября — день, когда суровая реальность продакшена разбивает любые теоретические предположения вдребезги.
Дело в том, что весь июль и август парсер и клиент отлаживались исключительно на тех PDF-файлах, которые были выложены на сайте колледжа по состоянию на 21 июня. А в конце июня выпускной 4 курс уже защитил дипломные проекты и благополучно покинул стены учебного заведения. В летних документах 4 курса не было вовсе. И мы допустили классическую, почти комичную ошибку начинающих разработчиков: мы настолько закопались в парсинг 1, 2 и 3 курсов, что даже на секунду не задумались о том, что в колледже попросту существует еще и 4 курс!
Когда утром 1 сентября учебная часть опубликовала свежие таблицы на осенний семестр, на сервер обрушился целый массив никем не жданных файлов и групп выпускного курса. Система к этому была абсолютно не готова: парсер мгновенно захлебнулся на незнакомых группах, регулярные выражения рассыпались, а в клиентском интерфейсе даже не было предусмотрено переключение на 4 курс.
Первые две недели сентября превратились в круглосуточный марафон хотфиксов. Мы на лету дописывали поддержку 4 курса в бэкенд и базу данных, адаптировали клиентские селекторы, переписывали регулярки прямо на живом сервере и тестировали парсинг по ночам на свежих документах.
Но этот стресс-тест принес потрясающие плоды: студенты мгновенно раскусили удобство сервиса. Ссылка на PWA разлеталась по старостатам и группам как лесной пожар. К середине сентября сервисом стабильно пользовались 50 человек каждый день (DAU). Это была первая настоящая победа.
6. Кризис 15 марта: Крах таблиц, официальный сайт-призрак и перерождение через Camelot
К весне 2026 года сервис вышел на пик устойчивой зрелости. Число активных ежедневных пользователей перешагнуло за 250 человек (DAU). Для колледжа со штатом учащихся около 800 человек это означало, что нашим PWA пользовалась добрая треть всех очников. Приложение открывали на каждой перемене.
А затем наступило 15 марта 2026 года — поворотный момент в судьбе проекта.
В этот день произошли сразу два взаимосвязанных события, перевернувших судьбу проекта:
- Диспетчерская учебной части кардинально обновила генератор PDF-документов: полностью поменялись шрифты, разметка страниц, структура шапок и геометрия таблиц.
- Одновременно с этим администрация колледжа с гордостью запустила собственный веб-ресурс расписания —
https://table-ci.nsu.ru/.
На первый взгляд, появление официального сайта должно было поставить крест на нашем независимом сервисе. Но реальность распорядилась иначе.
Официальный сайт оказался мертворожденным продуктом: он постоянно сбоил, путал четные и нечетные недели, отображал фантомные пары в неверных кабинетах, а по состоянию на сентябрь 2026 года и вовсе окончательно упал, отдавая глухую сетевую ошибку при попытке входа.
Однако и наше приложение постигла тяжелейшая катастрофа: старый парсер первого поколения, построенный на хрупких эвристиках времен VkiHub и параметре line_scale=55, оказался бессилен перед новым форматом. Таблицы рассыпались, ячейки склеились в нечитаемую кашу, а в базу данных полился мусор. Личные сообщения разрывались от сотен тревожных вопросов студентов: «Где расписание? Что случилось?».
Смерть вайбкодинга и осознанный реверс-инжиниринг
Именно 15 марта я окончательно осознал: слепой вайбкодинг не имеет права находиться в продакшене.
Нельзя было просто скормить новый кривой PDF чат-боту и надеяться, что нейросеть за тебя поймет природу артефактов рендеринга. Пришлось отложить все дела, открыть исходники библиотеки Camelot, документацию OpenCV и разобраться в математике детекции векторных контуров.
Camelot работает в двух базовых режимах:
stream— строит колонки на основе физических расстояний между словами и пробелами в тексте.lattice— опирается на компьютерное зрение OpenCV, находя пересечения видимых векторных линий сетки таблицы.
Главная коварная ловушка нового формата ВКИ заключалась в том, что разделительные линии ячеек в PDF были ультратонкими — так называемыми волосяными линиями (hairlines) толщиной менее 0.5 пункта. Стандартный алгоритм Camelot с дефолтным параметром масштабирования line_scale=15 и даже наш прежний line_scale=55 воспринимали их как шум растрирования и безжалостно отбрасывали, склеивая соседние пары в одну огромную ячейку.
Спасение пришло благодаря ювелирной калибровке физических параметров:
- Экстремальный масштаб
line_scale=100: увеличение коэффициента заставило морфологические ядра OpenCV реагировать даже на тончайшие субпиксельные векторные разделители. - Стыковка разрывов
joint_tol=4иline_tol=2: эти параметры задали допустимую погрешность рендеринга линий в точках их пересечения, надежно устраняя микроскопические разрывы и замыкая контуры ячеек. - Размножение объединенных ячеек
copy_text=['h', 'v']: автоматическое копирование текста по вертикали и горизонтали гарантировало, что потоковые лекции не потеряют привязку к подгруппам. - Переход на бэкенд Poppler: для максимальной точности растрирования страниц.
tables = camelot.read_pdf(
    path,
    pages='all',
    copy_text=['h', 'v'],
    line_scale=100,
    joint_tol=4,
    line_tol=2,
    backend='poppler'
)

for t in tables:
    matrix = self.table_to_matrix(t.df.values.tolist(), file_url)
    data = self.merge(data, matrix)
Но извлечь предсказуемую матрицу таблицы через Camelot было лишь половиной победы. Из-за кардинальной смены шаблона генерации PDF полностью сломались и все прежние методы разбора содержимого: преподаватели намертво склеивались с названиями предметов, номера кабинетов оказывались внутри темы пары, а новый формат учебной части стал содержать множество разнородных служебных пометок («дистант», «консультация», «выставление задолженностей», «экзамен»).
Весь внутренний конвейер нормализации и семантического анализа ячеек пришлось полностью переписать с чистого листа. Сердцем нового парсера стал метод parse_cell(self, text: str):
def parse_cell(self, text: str):
    if not text or not text.strip():
        return None

    text = self.clean_text(text)

    teacher = self.extract_teacher(text)
    classroom = self.extract_room(text)
    isDistance = 'дистанцион' in text.lower() or 'дистант' in text.lower()
    isLecture = 'лекци' in text.lower()
    lesson_text = self.extract_subject(text)
    lesson = self.normalize_lesson(self.remove_duplicate_words(lesson_text))

    if not lesson:
        return None

    if len(lesson.strip()) <= 3 or re.match(r'^[А-ЯЁA-Z]\.?\s*[А-ЯЁA-Z]?\.?$', lesson.strip(), re.IGNORECASE):
        return None

    if not teacher:
        m = re.search(r'\b([А-ЯЁ][а-яё]+(?:ова|ева|ина|ына|ский|цкий|ов|ев|ин|ын|ич|их|ых|юк|ук|ак))\s*$', lesson)
        if m:
            teacher = m.group(1)
            lesson = lesson[:m.start()].strip()

    formatted_lesson = None
    if lesson:
        if lesson.isupper():
            formatted_lesson = lesson[0].upper() + lesson[1:].lower()
        else:
            formatted_lesson = (lesson[0].upper() + lesson[1:]) if lesson.lower() == lesson else lesson

    if classroom and formatted_lesson:
        formatted_lesson = formatted_lesson.replace(classroom, '').strip()

    if formatted_lesson:
        formatted_lesson = re.sub(r'[\s.,:;_-]+$', '', formatted_lesson)

    isIssusing = 'выставле' in text.lower() or 'задолженност' in text.lower() or ('пар' in text.lower() and 'нет' in text.lower()) or not lesson

    return {
        'line': self.remove_duplicate_words(text) if isIssusing else text,
        'lesson': formatted_lesson,
        'teacher': teacher,
        'classroom': classroom,
        'isLecture': isLecture,
        'isDistance': isDistance,
        'isPractice': bool(re.search(r'\bпракт', text.lower())),
        'isExam': 'экзам' in text.lower(),
        'isIssusing': isIssusing,
        'isConsultation': 'консул' in text.lower(),
        'isCanceled': 'отмен' in text.lower()
    }
Этот алгоритм превратил хаотичный текст из сырых PDF-ячеек в строго типизированную структуру:
- Извлекает аудиторию и аккуратно вырезает ее номер из названия предмета, если они визуально слиплись при рендеринге.
- Находит преподавателя, а если регулярное выражение не сработало — подключает умный эвристический детектор русских фамилий по суффиксам (
-ова,-ский,-ин,-ев). - Очищает строку от дублирующихся токенов и шума с помощью
remove_duplicate_words. - Автоматически типизирует занятие набором булевых флагов (
isLecture,isPractice,isExam,isDistance,isConsultation,isCanceled,isIssusing), благодаря чему клиентский интерфейс получил возможность подсвечивать пары соответствующими бейджами и цветами.
Новый парсер стал монолитным, пуленепробиваемым танком. Сервис вернулся к жизни всего за несколько суток, а к концу учебного года аудитория выросла до 300 зарегистрированных аккаунтов, 200 постоянных DAU и свыше 1000 уникальных посетителей в месяц (MAU).
7. Продуктовая гигиена: Демонтаж форума и трансформация в хаб «Учёба»
К августу 2026 года пришло время трезвой и честной продуктовой ревизии сервиса перед новым учебным годом. И главным кандидатом на пересмотр стал наш закрытый студенческий форум.
С точки зрения архитектуры и вложенного труда форум был великолепен: выверенные интерфейсы, древовидные ветки, система бейджей, строгий кулдаун от спама, интеграция с корпоративной почтой. Но с точки зрения реальной жизни он оказался практически мертвым. За целый учебный год там появилось всего несколько десятков публикаций.
Мы провели глубокий анализ и выделили четыре фундаментальные причины провала:
- Психологический профиль аудитории: на направление программирования в колледжи традиционно поступает немало интровертных ребят, не склонных к публичным дискуссиям на незнакомых площадках. Руководство колледжа даже регулярно организует специальные внеучебные мероприятия для адаптации и социализации студентов.
- Тяжелый переход ко взрослой жизни: первокурсники и второкурсники сталкиваются с колоссальным стрессом: адаптация к сессиям, новым преподавателям, самостоятельной жизни и быту. У них банально нет свободного ресурса писать пространные посты на отдельном сайте.
- Непобедимая привычка к Telegram: у каждого курса, отделения и группы уже есть свои живые Telegram-чаты, где студенты общаются годами. Переманивать их на сайт ради того же самого общения оказалось утопией.
- Quick-lookup сценарий использования: в расписание человек заходит ровно на 5–10 секунд: быстро выхватить глазами номер аудитории перед звонком и убрать телефон в карман. Никто не приходит в утилитарный справочник ради долгого чтения ленты.
Держать раздутую кодовую базу ради мертвого раздела было грубой инженерной ошибкой. 27 августа 2026 года одним коммитом мы удалили 75 файлов и 4497 строк кода форума.
Это был болезненный, но критически важный шаг профессионального взросления: настоящий инженер должен уметь выбрасывать свой код, если он не приносит пользы людям.
Рождение академического хаба «Учёба» (/study)
Освободившуюся центральную вкладку занял принципиально новый функциональный модуль, сфокусированный исключительно на решении практических проблем студента:
- Мониторинг свободных аудиторий в реальном времени (
/classrooms): интерактивный инструмент, позволяющий в один клик увидеть, какие кабинеты свободны прямо сейчас на текущую пару или в выбранный день недели. Список наглядно разделен на свободные и занятые помещения с возможностью добавлять кабинеты в избранное. А если свободных аудиторий не осталось вовсе, интерфейс с самоиронией выводит иллюстрированные карточки: «Аудиторий нет, но вы держитесь — всё занято, кроме нашей надежды» в часы пик или «Шведский стол, но из аудиторий — когда мест больше, чем студентов» в полупустом корпусе. - Умная навигация и контекстные подсказки (
ClassroomTooltipи 2GIS):- Не все занятия проходят в стандартных номерных кабинетах: в расписании часто встречаются локации вроде «читальный зал-А», «актовый зал», «спортзал» или «студ.комп.бюро». В компактной мобильной карточке пары длинные фразы не помещаются в бейдж аудитории, поэтому интерфейс аккуратно заменяет их на лаконичные плашки (например,
ЧЗ-А) и тематические иконки. А при тапе на бейдж всплываетClassroomTooltip, показывающий полное человекочитаемое название помещения («Читальный зал-А», «Студенческое компьютерное бюро», «Спортзал», «Актовый зал», «Дистанционно»). - Если занятие проходит в главном кампусе университета (ГК / КПА), в карточке появляется специальный кликабельный бейдж со ссылкой на 2GIS (
MapNsuLecture), который сразу открывает нужный корпус на карте, избавляя первокурсников от паники перед поездкой в университетский городок.
- Не все занятия проходят в стандартных номерных кабинетах: в расписании часто встречаются локации вроде «читальный зал-А», «актовый зал», «спортзал» или «студ.комп.бюро». В компактной мобильной карточке пары длинные фразы не помещаются в бейдж аудитории, поэтому интерфейс аккуратно заменяет их на лаконичные плашки (например,
- Шторка быстрой сверки расписания (Verify Schedule Sheet): студенты часто испытывают понятную тревогу: «А вдруг сервис ошибся, не учел перенос или пара отменена?». В карточку расписания мы встроили шторку верификации. В один тап студент может свериться с первоисточником: открыть прямую ссылку на оригинальный PDF-документ учебной части, из которого были извлечены данные, либо перейти на официальный сайт колледжа.
- Разделение на «Дневник» (
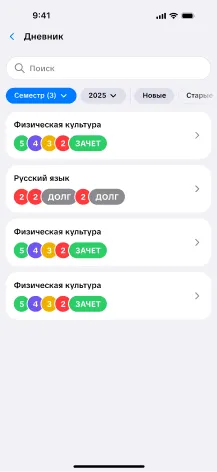
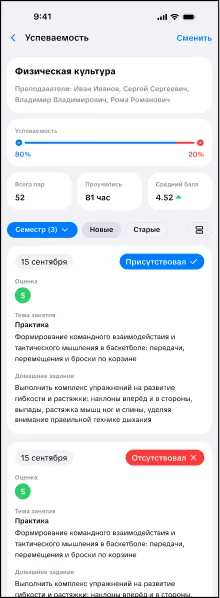
/journal) и «Зачётку» (/grade): хаб объединил два фундаментальных академических сценария через сессионную интеграцию с личным кабинетом НГУ (cab.nsu.ru):- Электронный дневник: отражает текущий недельный ритм семестра — домашние задания, темы занятий, фиксацию пропусков (буквы «Н») и текущие баллы с цветовой дифференциацией контрольных, контрольных недель и зачетов.
- Электронная зачётная книжка: извлекает официальные сессионные ведомости за все курсы обучения. Сессионный метод
grade(self)парсит номер зачетки, специальность, экзаменационные оценки с фамилиями преподавателей, а также рассчитывает общий средний балл и итоговый балл диплома:
async def grade(self):
    try:
        headers = {
            'Cookie': self.cookie,
            'X-Requested-With': 'XMLHttpRequest',
            'Referer': 'https://cab.nsu.ru/student/grade'
        }
        async with self.session.get('/student/grade?load-widget=true', headers=headers) as r:
            if len(r.history) != 0 or r.status == 403:
                return None

            soup = BS(await r.text(), 'html.parser')
            header = soup.find('div', class_='block-header')
            if not header:
                return None

            number = ''
            specialty = ''
            for title in header.find_all('h4', class_='block-header-title'):
                title_text = title.text.strip()
                if 'Номер:' in title_text:
                    number = title_text.replace('Номер:', '').strip()
                elif 'Специальность:' in title_text:
                    specialty = title_text.replace('Специальность:', '').strip()

            average_rating = ''
            diploma_rating = ''
            for store_block in header.find_all('div', class_='average-store'):
                store_title = store_block.find('div', class_='title')
                store_val = store_block.find('div', class_='store')
                if store_title and store_val:
                    st_text = store_title.text.strip()
                    if 'Общий средний балл' in st_text:
                        average_rating = store_val.text.strip()
                    elif 'Средний балл диплома' in st_text:
                        diploma_rating = store_val.text.strip()

            terms = []
            tab_panes = soup.find_all('div', class_='tab-pane')
            for pane in tab_panes:
                pane_header = pane.find('h4', class_='block-header-title')
                pane_title = pane_header.text.strip().replace('Успеваемость за ', '').strip() if pane_header else pane.get('id', '')

                subjects = []
                for item in pane.find_all('div', class_='item-grade'):
                    name_el = item.find('div', class_='name')
                    name = name_el.text.strip() if name_el else ''

                    mark_el = item.find('span', class_='mark')
                    mark = mark_el.text.strip() if mark_el else ''
                    mark_classes = mark_el.get('class', []) if mark_el else []
                    mark_type = next((c for c in mark_classes if c != 'mark'), '')

                    kurs_el = item.find('div', class_='kurs')
                    date = kurs_el.text.replace('Дата:', '').strip() if kurs_el else ''

                    isp_el = item.find('div', class_='isp')
                    attestation_type = isp_el.text.replace('Форма аттестации:', '').strip() if isp_el else ''

                    teacher_el = item.find('div', class_='teachers')
                    teacher = ''
                    if teacher_el:
                        teacher_span = teacher_el.find('span')
                        if teacher_span:
                            teacher = teacher_span.text.strip()
                        else:
                            teacher = teacher_el.text.replace('Преподаватель:', '').strip()

                    subjects.append({
                        'name': name,
                        'mark': mark,
                        'mark_type': mark_type,
                        'date': date,
                        'type': attestation_type,
                        'teacher': teacher
                    })

                terms.append({
                    'title': pane_title,
                    'subjects': subjects
                })

            return {
                'number': number,
                'specialty': specialty,
                'average_rating': average_rating,
                'diploma_rating': diploma_rating,
                'terms': terms
            }
    except Exception:
return None-
Официальные приказы колледжа (
/orders) и страница «Звонки» (/bells): Для полного закрытия академических потребностей мы реализовали структурированный парсинг официальных приказов руководства колледжа (о зачислении, стипендиях, академических переводах и отчислениях), а также вынесли в быстрый доступ расписание звонков для обеих смен. Больше не нужно искать по коридорам распечатанную сетку звонков — точное время начала и конца каждой пары и перемены доступно оффлайн в один клик. -
Фоновый демон автопушей оценок (
NsuMarksNotify): асинхронный воркер каждые 30 минут в фоне опрашивает успеваемость подписанных студентов. Если обнаруживается новая оценка через метод_detect_new_marks, сервер моментально генерирует системный Web Push. Студент видит четверку или пятерку на экране блокировки смартфона еще до того, как преподаватель успеет объявить оценки вслух:
changes = self._detect_new_marks(old_term, new_term)
if changes:
    for change in changes:
        title = f'Новая оценка по {change['subject']}'
        text = f'В журнал добавлена оценка {change['mark']} по предмету {change['subject']}. Проверьте детали в приложении.'
        Util.sendWebPush(Util.buildSubscriptionInfo(user), {'title': title}, text)
        await NsuNotificationManager.create(
            user=user,
            notify_type='new_mark',
            title=title,
            message=text,
            data={'subject': change['subject'], 'mark': change['mark']}
        )
Так в приложении сформировалась полноценная экосистема электронного дневника и зачетки с наглядным отображением задолженностей и предметов.
А на экране детального просмотра студент получил доступ к среднему баллу, статистике посещаемости и ведомостям.
8. Итоги и инженерные выводы
К сентябрю 2026 года сервис остается абсолютно независимым продуктом. Колледж вряд ли когда-то сделает его официальным ресурсом, да и в этом нет никакой практической нужды. Пока официальный сайт расписания лежит с сетевой ошибкой, наше PWA работает каждое утро в смартфонах сотен учащихся и преподавателей, помогая им не опаздывать на пары. Проект давно перерос рамки сугубо студенческого справочника: преподаватели колледжа ежедневно смотрят в нем свои педагогические нагрузки и «окна», а старосты находят свободные кабинеты для консультаций и сдачи академических хвостов.
Итоговый технологический стек
| Область | Технологии |
|---|---|
| Frontend | React 19, TypeScript, Vite, PWA (vite-plugin-pwa, Cache Storage), Capacitor, Redux Toolkit, React Router 7, SCSS Modules, Tabler Icons |
| Backend | Python, FastAPI, Uvicorn, Tortoise ORM, PostgreSQL (asyncpg), Pydantic v2 |
| Парсинг & PDF | Camelot (lattice, OpenCV), PyMuPDF, Pandas, BeautifulSoup4 |
| Инфраструктура | Linux VDS, Nginx (SSL Let’s Encrypt, HTTP/2, Gzip), Web Push (VAPID) |
Оглядываясь назад на этот полуторагодовой путь проб, ошибок и бессонных ночей, я могу сформулировать три главных инженерных вывода:
- Вайбкодинг хорош только как искра для ночной проверки гипотезы. Быстро набросать прототип и пощупать концепт — прекрасно. Но тащить непонятый код в продакшен — это бомба замедленного действия. Настоящая надежность появляется только тогда, когда ты сам досконально понимаешь
line_scale,joint_tol, устройство жизненного цикла Service Worker и структуру сетевых сессий. - Умение удалять код важнее умения его писать. Выбрасывать написанный за недели код форума было эмоционально тяжело. Но именно удаление 4500 строк мертвого кода превратило проект из перегруженного комбайна в быстрый, сфокусированный и любимый студентами инструмент. Влюбляться нужно в решение проблемы пользователя, а не в собственные строчки кода.
- PWA — абсолютное супероружие для независимой разработки. Возможность не платить по 99 долларов за лицензии сторов, обходить бюрократическую модерацию, доставлять обновления за секунды и давать людям полноценный офлайн-опыт делает веб идеальной платформой для локальных сообществ.
Инженерия — это не про следование модным трендам. Это про смелость взять сломанный, неудобный PDF-документ и превратить его в инструмент, который каждое утро делает жизнь живых людей вокруг тебя хоть немного легче.
Огромная благодарность дизайнеру Арлену за визуальный стиль, терпение к бесконечным правкам макетов и общую веру в проект.